AI資料中心為什麼需要壓力錶與溫度計?從液冷機房到氣冷機架的完整儀表監測指南
發佈日期:2026年9月|作者:ATLANTIS應用工程團隊|適用對象:資料中心設施工程師、IT基礎設施經理、液冷系統設計師、機電統包商
當一顆AI訓練用GPU的單卡熱設計功耗(TDP)從250瓦一路衝上700瓦、甚至逼近1000瓦,傳統風冷機房早已無法負荷。液冷(Liquid Cooling)從「選配」變成「標配」,冷卻液分配單元(CDU)、歧管(Manifold)、快接頭(Quick Disconnect)、板式熱交換器(PHE)在機房裡快速蔓延。但很少有人問一個最基本的問題:這套液冷系統,你怎麼知道它現在到底安不安全、有沒有在正常運作?
答案不是靠感覺,也不是靠GPU降頻警報才後知後覺——而是靠壓力錶與溫度計,在每一個關鍵節點,把看不見的流體狀態變成看得見的數字。一套AI資料中心的液冷迴路,從主環路到二次側機架分歧、從CDU進出口到伺服器冷板,壓力與溫度是唯一能即時告訴你「系統是否健康」的兩個變數。少了它們,你的百萬美元GPU叢集,其實是蒙著眼睛在跑。
本文將從系統架構出發,拆解一座現代AI資料中心(無論是氣冷、單相液冷或兩相浸沒式液冷)究竟需要哪些壓力與溫度儀表、裝在哪裡、為什麼、以及選型時最容易犯的錯誤。這是一篇寫給真正要面對機房、面對PLC點位表、面對CDU廠商規格書的工程師看的實戰指南,而不是行銷術語的堆疊。全文從系統架構解析出發,依序拆解負載特性帶來的風險、完整的儀表清單與選型邏輯、實際可導入的產品方案、真實案例的量化成效,最後以工程師最常提出的問題作結,希望能成為您規劃或檢視AI資料中心液冷監測系統時,一份可以反覆查閱的實用參考。
第一章:AI資料中心的熱管理架構與完整儀表需求地圖
1.1 為什麼AI機房的散熱邏輯跟傳統機房完全不同
傳統資料中心的散熱邏輯很單純:機架功率密度大約落在5~10 kW,靠CRAC(電腦室空調機)或CRAH(電腦室空氣處理機)吹出冷風,透過地板下送風或熱通道圍封,把伺服器排出的熱氣帶走。整套系統的監測重點是「風」——風量、風壓、送風溫度、回風溫度。
但AI訓練機架完全是另一個世界。單一機櫃塞進8張、甚至72張GPU(如NVL72機櫃),機架功率密度衝到40 kW、80 kW,最新的高密度液冷機櫃甚至逼近120 kW以上。這種功率密度下,空氣的比熱與密度已經完全不夠用——水的比熱是空氣的約3,500倍(以相同體積計算),這正是液冷成為AI機房唯一可行方案的物理原因。
當散熱介質從「空氣」換成「液體」,監測的邏輯也徹底改變。空氣系統你關心風量與溫差;液冷系統你必須同時盯緊壓力與溫度兩個變數,而且是在多個層級、多個節點同步監測——因為液冷系統一旦出問題,不是效能下降這麼簡單,而是漏液、汽蝕(Cavitation)、流量不足導致熱點(Hot Spot),每一種都可能造成價值數千萬元的GPU伺服器瞬間報廢。
1.2 三種主流液冷架構與各自的儀表需求
目前AI資料中心採用的液冷技術主要分為三種,每一種對壓力錶與溫度計的需求都不完全相同:
① 直接晶片式液冷(Direct-to-Chip, D2C)/冷板式液冷
冷卻液不直接接觸電子元件,而是透過安裝在GPU、CPU上的冷板(Cold Plate)把熱量帶走。這是目前最主流的AI機房液冷方案。整條迴路分為一次側(Facility Loop,連接冷卻水塔或氣冷式熱交換器)與二次側(Technology Loop,連接伺服器冷板),中間由CDU(Coolant Distribution Unit,冷卻液分配單元)做熱交換與流量調節。壓力與溫度儀表分布在CDU進出口、機架歧管(Manifold)進出口、伺服器冷板進出口。
② 兩相浸沒式液冷(Two-Phase Immersion Cooling)
伺服器整台浸泡在特殊工程流體(通常是氟化液)中,透過液體沸騰、蒸氣冷凝的相變化帶走熱量。這種架構對槽體內壓力的監測要求極為嚴苛,因為系統必須維持在接近大氣壓的密閉環境,壓力異常升高代表冷凝效率不足、蒸氣外洩風險增加。
③ 單相浸沒式液冷(Single-Phase Immersion Cooling)
伺服器浸泡在不導電的礦物油或合成油中,透過液體循環(而非相變)帶走熱量。監測重點與D2C類似,但流體黏度較高,壓差量測需要考慮管路阻力的特殊設計。
不論採用哪一種架構,壓力錶與溫度計扮演的角色本質相同:它們是系統健康狀態的唯一即時證據。控制系統可以顯示流量、可以顯示PUE,但真正能在異常發生的第一時間告訴你「哪裡出問題」的,往往是壓力與溫度的瞬間變化。
1.3 AI資料中心液冷迴路完整儀表點位地圖
以一套典型的D2C冷板式液冷系統為例,從冷卻水源到GPU冷板,完整的壓力與溫度監測點位如下:
| 迴路位置 | 監測項目 | 監測目的 | 典型儀表類型 |
|---|---|---|---|
| 冷卻水塔/乾式冷卻器出口 | 溫度、壓力 | 確認一次側冷源供應狀態 | 溫度傳送器、壓力傳送器 |
| CDU一次側入口 | 壓力、溫度 | 監控外部供水壓力是否穩定 | 壓力錶、Pt100溫度計 |
| CDU一次側出口 | 壓力、溫度 | 確認熱交換效率 | 壓力傳送器、溫度傳送器 |
| CDU二次側入口(供水) | 壓力、溫度、差壓 | 監控送往機架的冷卻液狀態 | 差壓傳送器、高精度溫度傳送器 |
| CDU二次側出口(回水) | 壓力、溫度 | 計算熱負荷(ΔT × 流量) | 壓力傳送器、Pt100 |
| 機架歧管(Manifold)供液側 | 壓力 | 確認各機架分配壓力均勻 | 小型數位壓力錶 |
| 機架歧管回液側 | 壓力、溫度 | 比對進出口溫差判斷散熱效果 | 壓力錶、溫度感測器 |
| 伺服器冷板入口 | 溫度 | 確認供液溫度在安全範圍 | 微型溫度感測器 |
| 伺服器冷板出口 | 溫度 | 偵測局部熱點 | 微型溫度感測器 |
| 過濾器/精密過濾網前後 | 差壓 | 判斷濾網阻塞程度 | 差壓傳送器、差壓開關 |
| 補液系統(Make-up Loop) | 壓力 | 監控系統液位與洩漏補償 | 壓力開關、壓力傳送器 |
| 快接頭(Quick Disconnect)前後 | 壓力驟降監測 | 即時偵測漏液或接頭鬆脫 | 差壓開關 |
從這張表格可以看出,一套完整的AI資料中心液冷系統,光是壓力與溫度的監測點位,動輒就是數十甚至上百個。這也是為什麼資料中心的儀表採購與選型,已經從「機電工程的配角」變成「決定系統可靠度的關鍵角色」。
1.4 氣冷機房仍然需要的儀表監測
即使是尚未導入液冷的傳統氣冷AI機房(例如中小型推論叢集或邊緣運算機房),壓力與溫度儀表同樣不可或缺:
- 冰水主機(Chiller)冷媒迴路:冷媒壓力直接反映系統效率與是否有冷媒洩漏,過低的冷媒壓力會導致蒸發溫度下降,壓縮機效率崩潰。
- 冰水盤管進出水壓差:用來判斷盤管是否結垢或堵塞,長期累積會顯著降低換熱效率。
- 高效濾網(HEPA)前後差壓:精密機房若有潔淨度要求,濾網阻塞會反映在差壓值上升。
- 地板下送風壓力:架高地板送風系統需要維持穩定靜壓,壓力不足會導致遠端機架供風量不足。
- 機架進風/出風溫度:直接反映熱通道圍封是否有效、是否有冷熱氣流混合(Bypass Air)的問題。
換句話說,不管是氣冷還是液冷,「壓力錶與溫度計」都是資料中心機電系統的神經末梢——沒有它們,再聰明的DCIM(資料中心基礎設施管理)軟體也只是個沒有輸入資料的空殼。
1.5 CDU(冷卻液分配單元)在壓力溫度控制中的核心角色
CDU是整套液冷系統的心臟,同時也是壓力與溫度監測最密集的單一節點。理解CDU的工作原理,是規劃整套儀表方案的第一步。CDU的核心功能有三個:透過板式熱交換器將一次側(設施冷卻水)與二次側(技術冷卻液)做熱交換隔離;透過內建循環幫浦維持二次側迴路的穩定流量與壓力;透過控制邏輯(通常搭配變頻幫浦與調節閥)依實際熱負荷動態調整輸出。
在這三個功能中,壓力與溫度扮演的角色分別是:壓力是幫浦控制邏輯的回授訊號——CDU需要知道二次側供液壓力是否維持在設計範圍內,才能決定是否要提高幫浦轉速;溫度則是熱交換效率的直接指標——透過比對一次側與二次側的進出口溫度,可以反推熱交換器是否有結垢、效率是否衰退的問題。
值得注意的是,許多CDU廠商內建的壓力與溫度顯示,其精度規格是針對「設備自我保護」設計,而非針對「精密能效分析」設計。也就是說,內建顯示或許足以讓CDU判斷「要不要跳機保護」,但若要用這些數據去精確計算PUE(電力使用效率)或WUE(用水效率),往往精度不足。這也是為什麼許多大型資料中心業主,會在CDU規格書中額外要求獨立、可校正、可追溯的高精度壓力溫度傳送器,作為能效計算的官方數據來源,而不完全信賴設備原廠內建的顯示模組。
1.6 依資料中心分級標準看監測需求的差異
資料中心的可靠度分級(常見如Tier I至Tier IV,或依各國標準略有差異)直接影響儀表監測系統的冗餘設計要求。分級越高,代表對單點故障(Single Point of Failure)的容忍度越低,儀表系統的設計邏輯也必須跟著調整:
| 可靠度需求層級 | 壓力溫度監測設計原則 | 典型冗餘配置 |
|---|---|---|
| 基礎型(單一路徑) | 關鍵節點單一感測器即可,著重異常警報功能 | 無冗餘,定期校正維持可靠度 |
| 中階型(部分冗餘) | CDU層級建議雙感測器交叉比對,避免單一感測器故障造成誤判 | 關鍵點位2選1或2取平均值邏輯 |
| 高可用型(並行維護容錯) | 每個獨立冷卻迴路皆須具備完整監測,且維護單一感測器時不影響系統判斷 | 雙迴路獨立監測,可線上校正不停機 |
| 容錯型(最高等級) | 感測器本身也須考慮備援策略,避免感測器故障誤導控制邏輯做出錯誤動作 | 三重感測器表決邏輯(2 out of 3 voting) |
在規劃AI資料中心的儀表配置時,建議在專案初期就明確定義該案場的可靠度目標,因為這會直接影響儀表數量、安裝方式(是否需要不停機更換的隔離閥設計)與預算規模。許多客戶在專案後期才發現監測系統冗餘度不足,此時要再加裝往往需要停機施工,對已上線營運的機房而言成本與風險都大幅提高。
第二章:AI訓練負載的尖峰特性與壓力溫度風險分析
2.1 AI訓練負載為什麼特別「尖」——功率曲線與熱管理的關係
與傳統雲端運算負載(相對平穩的CPU使用率曲線)不同,AI大型語言模型訓練的功率曲線呈現高度的「同步脈衝」特性。當數千張GPU在同一個訓練批次(Batch)中同步進行梯度計算與AllReduce通訊時,整個叢集的功耗會在毫秒到秒級的時間尺度上劇烈波動——業界稱為「Power Swing」或「功率抖動」。
這種功率抖動對冷卻系統造成的衝擊,遠比穩態負載更嚴苛。當數千張GPU同時從閒置狀態切換到滿載狀態,瞬間的熱負荷可以在數秒內從機架的30%躍升至95%以上,這對冷卻液的流量與壓力系統形成了近似「水錘效應(Water Hammer)」的衝擊波。若壓力監測系統的響應速度不夠快、若CDU的流量調節閥反應遲鈍,這種瞬間壓力波動足以造成快接頭鬆動、軟管接頭疲勞、甚至隔膜元件的機械性損壞。
2.2 壓力異常的五大風險情境
在AI資料中心液冷系統中,壓力異常通常對應以下五種風險情境,每一種都需要不同層級的監測策略:
情境一:過濾器堵塞導致的漸進式壓力上升
冷卻液中的微粒(來自管路氧化、密封件磨損、初次安裝時殘留的焊渣)會逐漸堆積在精密過濾器上。這種堵塞是漸進式的,通常需要數週到數月才會發展到臨界點。監測方式是在過濾器前後裝設差壓傳送器,設定分級警報(例如差壓達到初始值的1.5倍時發出預警,達到2倍時強制停機更換)。
情境二:快接頭鬆脫或軟管疲勞導致的壓力驟降
這是最危險的情境之一。快接頭若因震動或安裝不良而鬆脫,會造成該分支迴路壓力瞬間下降,同時伴隨漏液風險。監測方式需要在關鍵分支點裝設高取樣率的壓力開關或差壓開關,並將訊號直接連動至緊急關斷閥(ESV),而非僅依賴人工巡檢。
情境三:CDU幫浦異常導致系統壓力全面偏移
CDU內建的循環幫浦若發生軸承磨損、葉輪腐蝕或變頻器故障,會導致整體系統壓力偏離設計值。這種異常通常是漸進的,但一旦幫浦完全故障,系統壓力會在數十秒內崩潰,直接影響下游所有機架的冷卻能力。CDU進出口的高精度壓力傳送器是偵測這類異常最有效的第一道防線。
情境四:汽蝕(Cavitation)風險
當系統某處的局部壓力低於冷卻液在該溫度下的飽和蒸氣壓時,液體會產生氣泡(汽蝕),氣泡潰滅時產生的局部高壓衝擊會侵蝕金屬表面,長期下來會造成幫浦葉輪、閥座、管路彎頭的機械性損傷。這種風險在CDU幫浦入口側(負壓區)特別容易發生,需要搭配絕對壓力量測與溫度資料交叉比對,才能準確評估汽蝕風險。
情境五:補液系統壓力異常反映的緩慢洩漏
液冷系統不可能做到100%零洩漏,密封件的微量滲漏是長期存在的現實。補液系統(Make-up Tank)的壓力與液位監測,本質上是在間接偵測整個系統的洩漏速率。當補液頻率異常增加,代表系統某處可能存在緩慢但持續的洩漏,需要透過壓力數據的長期趨勢分析才能及早發現,而不是等到液位過低跳機才處理。
2.3 溫度異常的風險層級與熱點偵測
相較於壓力異常通常反映「流體路徑」的問題,溫度異常則更直接反映「熱源與散熱能力的失衡」。AI機房的溫度監測需要區分三個層級:
| 監測層級 | 典型溫度範圍 | 異常代表的風險 | 反應時間要求 |
|---|---|---|---|
| 設施層(Facility Loop) | 供水15~25°C | 冷源供應不足,影響全機房 | 分鐘級 |
| 機架層(Rack Manifold) | 供液20~35°C | 該機架散熱異常,可能是流量分配不均 | 秒級 |
| 晶片層(Cold Plate) | 出口可達45~60°C | 局部熱點,GPU可能已開始降頻保護 | 毫秒至秒級 |
值得特別強調的是「晶片層」溫度監測的重要性。現代GPU內建的溫度感測器雖然能反映晶粒(Die)本身的溫度,但這是「果」而非「因」——當GPU溫度感測器報警時,代表冷卻液早已未能有效帶走熱量。真正能做到預防性維護的做法,是在冷板出口裝設快速響應的溫度感測器,透過監測冷板進出口溫差(ΔT)的趨勢變化,在GPU降頻發生之前,就先偵測到散熱能力的衰退。
2.4 尖峰負荷情境下的儀表響應速度要求
傳統工業應用對儀表響應速度的要求,多半落在秒級到分鐘級即可滿足製程控制需求。但AI訓練負載的功率抖動週期可能短至數百毫秒,這對壓力與溫度儀表的動態響應能力提出了截然不同的規格要求:
- 壓力傳送器的響應時間:建議選用響應時間在毫秒等級(<10ms)的擴散矽或陶瓷電容式感測元件,避免使用機械式波登管結構作為快速監測的主要手段(波登管更適合人工目視讀值,而非高頻率的自動監測)。
- 溫度感測器的時間常數:薄膜型Pt100的響應速度明顯優於傳統繞線型RTD,在需要捕捉快速溫度變化的冷板出口監測點,薄膜型設計是更合適的選擇。
- 資料採樣與記錄頻率:關鍵節點的壓力與溫度數據,建議採樣頻率不低於1Hz,並具備本地緩存與事件觸發式高頻記錄能力(例如偵測到異常時自動切換至100Hz採樣),以利事後的故障根因分析。
這也直接影響了儀表選型的邏輯——並非所有壓力錶、溫度計都適合用在AI資料中心的關鍵監測點。選型時必須同時考慮精度、響應速度、長期穩定性,以及與既有監控系統(BMS/DCIM)的通訊相容性(如HART、Modbus RTU、4-20mA)。
2.5 水錘效應與機架分支管路的機械疲勞風險
當數千張GPU在同一訓練批次中同步切換負載狀態,二次側迴路的流量需求也會跟著劇烈變化。如果CDU的變頻幫浦與調節閥反應速度跟不上這種負載切換頻率,管路內會產生類似「水錘效應」的壓力衝擊波——流體流速在極短時間內驟然改變,衝擊波沿著管路傳遞,對彎頭、閥門、快接頭等機械連接點形成反覆的應力衝擊。
這種機械疲勞風險的危險之處在於它是「累積性」的——單一次的壓力衝擊或許不會造成立即可見的損壞,但數萬次、數十萬次的反覆衝擊,會逐漸使密封件材質疲勞劣化、螺紋連接鬆動、甚至造成金屬管件的疲勞裂紋。這也是為什麼AI資料中心液冷系統的可靠度評估,不能只看「當下的壓力是否在正常範圍」,還必須關注「壓力波動的頻率與幅度是否在合理範圍內」。
具備高採樣頻率記錄能力的壓力傳送器,能夠捕捉並記錄這類瞬態壓力波動的完整波形,透過長期累積的數據分析,工程師可以評估特定機架分支是否存在異常頻繁的壓力衝擊事件,及早排查是否為CDU控制邏輯需要調校、或是該分支的管路設計存在共振風險,在機械疲勞發展至實際洩漏或損壞之前完成預防性介入。
2.6 監測策略的分層設計:從被動警報到主動預測
綜合前述的風險情境分析,AI資料中心的壓力溫度監測策略,應該依照系統成熟度分為三個層次逐步建構:
| 監測成熟度層次 | 核心能力 | 典型作法 |
|---|---|---|
| 第一層:被動警報 | 數值超出安全範圍時發出警報 | 固定門檻值警報,人工介入處理 |
| 第二層:趨勢分析 | 透過歷史數據識別漸進式異常 | 差壓、溫差趨勢圖表,定期人工檢視 |
| 第三層:主動預測 | 結合多變數數據預測潛在故障,提前排程維護 | 整合壓力、溫度、流量多維度數據,建立預測性維護模型 |
多數資料中心目前仍停留在第一層或第二層,但隨著AI機房規模持續擴大、單一故障事件的成本持續攀升,導入第三層的主動預測能力,正逐漸成為大型企業級資料中心的標準配置目標。而無論最終要達到哪一個層次,前提都是必須先擁有完整、準確、高頻率的原始壓力與溫度數據——這正是壓力錶與溫度計作為整套監測體系基礎建設的核心價值所在。
第三章:完整儀表清單與系統配置對照表
3.1 依監測位置分類的儀表選型清單
以下表格整理出一套典型AI資料中心液冷系統中,各個監測位置建議採用的儀表類型、規格重點與連接方式,作為採購規格書的參考基礎:
| 系統區域 | 儀表項目 | 建議精度 | 輸出訊號 | 連接方式 |
|---|---|---|---|---|
| CDU一次側/二次側 | 高精度壓力傳送器 | ±0.1%~±0.5% | 4-20mA / HART | 螺紋直裝或隔膜座 |
| CDU出水溫度 | 白金電阻溫度計(Pt100) | ±0.1°C(A級) | 4線制 / HART | 套管式安裝 |
| 過濾器前後 | 差壓傳送器 | ±0.5% | 4-20mA | 雙隔離閥岐管 |
| 機架歧管供液 | 小型數位壓力錶 | ±0.5% | 本地顯示 / 4-20mA | 快接頭或螺紋 |
| 冷板進出口 | 微型溫度感測器 | ±0.1~0.3°C | 類比或數位 | 管路內嵌式 |
| 補液系統 | 壓力開關/壓力傳送器 | ±1% | 開關訊號 / 4-20mA | 螺紋直裝 |
| 快接頭監測 | 差壓開關 | 設定點可調 | 開關訊號 | 管路旁通 |
| 機房環境(氣冷區) | 溫濕度傳送器 | 溫度±0.3°C/濕度±2%RH | 4-20mA / Modbus | 壁掛或風管型 |
| 資料記錄與追溯 | 多點溫度記錄器 | ±0.5°C | 本地儲存 / 匯出 | 攜帶式或固定式 |
3.2 精度等級選擇的邏輯:不是越精密越好
很多初次接觸資料中心液冷專案的工程師,會直覺認為「精度越高越安全」,因此在規格書上一律要求最高精度等級的儀表。這其實是一種資源錯置——過度規格化不僅墊高整體專案成本,某些場合下反而會犧牲儀表的耐用性與響應速度(高精度感測元件往往對震動與溫度波動更敏感)。
正確的做法是依照「監測目的」決定精度等級:
- 安全連鎖與跳機保護點:精度要求可以相對寬鬆(±1%~±2.5%),但重複性(Repeatability)與響應速度必須優先考慮,因為這類點位關心的是「是否超過門檻」,而非精確數值。
- 製程優化與能效計算點(如ΔT計算):需要高精度(±0.1%~±0.5%),因為這些數值會直接用於計算PUE、冷卻效率等關鍵績效指標,微小誤差經過長期累積會嚴重扭曲能效分析結果。
- 研發測試與標準校驗點:需要最高精度等級(±0.05%~±0.1%),通常用於新型冷板設計驗證或供應商設備驗收測試。
3.3 材質與耐蝕性考量:冷卻液相容性
AI資料中心液冷系統使用的冷卻液種類繁多,從去離子水、丙二醇水溶液(PG25/PG50),到兩相浸沒式使用的氟化液,每一種對儀表接液材質的相容性要求都不同:
| 冷卻液類型 | 建議接液材質 | 特別注意事項 |
|---|---|---|
| 去離子水(DI Water) | 316L不鏽鋼、PEEK | 需注意電導度控制,避免與異質金屬產生電化學腐蝕 |
| 丙二醇水溶液 | 316L不鏽鋼 | 黏度較高,差壓量測需考慮阻力係數修正 |
| 氟化液(兩相浸沒) | 不鏽鋼、特殊氟橡膠密封 | 需確認密封材質與氟化液的長期相容性 |
| 礦物油(單相浸沒) | 不鏽鋼、氟橡膠 | 油品黏度隨溫度變化大,需選用寬溫域補償設計 |
選錯接液材質的後果不是立即發生,而是在數月到一年後逐漸浮現——密封件劣化、隔膜疲勞、感測元件漂移,最終表現為量測數值的緩慢失準,而這種緩慢失準往往比儀表完全故障更危險,因為系統仍然「看起來」在正常運作,實際上數據已經不可信。這也是為什麼在專案採購階段,建議明確要求供應商針對特定冷卻液種類提供相容性確認文件,而非僅憑一般工業標準材質規格就直接採用,畢竟資料中心液冷系統的運作環境雖然溫和,但要求的是數年甚至十年以上的長期穩定性,任何微小的材質相容性疏漏,經過長時間累積都可能演變成難以預期的維護負擔。
3.4 通訊協議與系統整合考量
現代資料中心的儀表已經不再是獨立運作的量測工具,而必須整合進DCIM(資料中心基礎設施管理)系統或BMS(建築管理系統),因此通訊協議的選擇直接影響系統整合的複雜度與未來擴充性:
- 4-20mA類比訊號:最傳統也最穩定的訊號傳輸方式,抗干擾能力強,適合長距離配線,但每個訊號點需要獨立配線,大型機房的配線成本較高。
- HART通訊:在既有4-20mA類比線路上疊加數位訊號,可同時取得製程變數與診斷資訊(如感測器健康狀態),且能相容既有的類比基礎設施,是資料中心液冷系統目前最常見的過渡方案。
- Modbus RTU/RS-485:可在同一條匯流排上串接多個測點,大幅降低配線成本,適合機架層級的密集監測點(如多個機架歧管壓力)。
- 乙太網路型通訊(Modbus TCP等):適合需要整合進IT網路架構、與DCIM軟體深度整合的高階應用。
在實務規劃中,建議依「設施層」與「機架層」分別選擇不同的通訊策略:設施層(CDU、冷卻水塔)因為點位數量相對較少但重要性極高,適合採用HART或獨立4-20mA確保訊號可靠度;機架層因為點位數量龐大(每機架可能有4~8個監測點),採用Modbus RTU匯流排架構更能有效控制配線成本與系統複雜度。
3.9 警報分級策略:避免「警報疲勞」的設計思維
當機房內有數百個壓力與溫度監測點時,如果每個點位的異常都以相同層級的警報方式呈現,維運團隊很快就會陷入「警報疲勞」——因為過多的低優先度警報淹沒了真正需要立即處理的高優先度事件,導致重要警報被忽略或延遲處理。這是大型AI資料中心在導入完整監測系統後,經常遇到的第二層挑戰(第一層挑戰是把儀表裝上去,第二層挑戰是把警報邏輯設計好)。
建議採用至少三個層級的警報分類架構:
| 警報層級 | 觸發條件範例 | 建議應對方式 |
|---|---|---|
| 資訊層級(Info) | 數值超出正常範圍但仍在安全裕度內,如差壓緩慢上升 | 記錄於趨勢報告,定期人工檢視,無需立即動作 |
| 警告層級(Warning) | 數值接近保護門檻,如壓力偏移超過設計值的15% | 即時通知值班工程師,排定近期檢修排程 |
| 緊急層級(Critical) | 數值已達安全連鎖保護門檻,如快接頭壓力驟降 | 自動觸發保護動作(降載或關斷),同步呼叫緊急應變人員 |
此外,警報邏輯也應該納入「延遲確認」機制,避免因感測器雜訊或瞬間干擾產生的假警報頻繁打擾值班人員——例如要求異常訊號持續超過設定時間(如3~5秒)才觸發警報,同時搭配前面提到的壓力溫度交叉比對邏輯,進一步降低誤報率,讓警報系統真正發揮「值得信賴」的效果,而不是被值班人員逐漸忽視的背景噪音。
3.8 資料記錄與異常事件回溯的系統設計
除了即時監測與警報功能,AI資料中心的儀表系統還必須考量「異常事件回溯」的能力。當GPU發生非預期降頻或伺服器異常關機時,維運團隊經常需要回溯事發當下前後數分鐘的壓力與溫度變化,才能準確判斷是散熱系統問題、還是晶片本身的其他故障。這對資料記錄系統提出了幾項具體要求:
- 連續歷史資料保存:關鍵監測點的數據建議至少保留90天以上的完整歷史紀錄,供長期趨勢分析與異常追溯使用。
- 事件觸發式高頻記錄:平常以較低頻率(如每秒一筆)記錄數據以節省儲存空間,但當偵測到異常事件時,自動切換為高頻率記錄(如每秒數十筆),完整捕捉事件發生當下的動態變化。
- 時間同步機制:所有監測點的時間戳記必須與IT系統(如GPU監控平台、叢集管理系統)保持精確同步,這樣才能在跨系統的故障分析中,準確比對機電系統異常與IT系統異常的時間關聯性。
這套資料記錄架構的價值,往往要到真正發生異常事件、需要向管理層或客戶交代根因分析報告時才會被凸顯出來。許多資料中心在專案初期為了節省成本,僅規劃即時警報功能而未妥善規劃歷史資料架構,結果在事後追查問題時,才發現關鍵的異常發生時段數據早已被覆蓋或根本沒有記錄,導致根因分析陷入僵局,這是規劃階段就應該避免的常見疏漏。
3.7 儀表數量估算:一座中型AI機房到底需要多少支壓力錶與溫度計
在專案初期進行預算規劃時,工程師經常需要快速估算整體儀表數量。以下提供一個簡化的估算邏輯,協助建立初步的採購規模概念(實際數量仍須依照現場架構調整):
| 機房規模參考 | 機架數量 | 壓力監測點估算 | 溫度監測點估算 |
|---|---|---|---|
| 小型AI推論叢集 | 10~20櫃 | 約15~30點(CDU層級為主) | 約20~40點 |
| 中型AI訓練機房 | 50~100櫃 | 約80~200點(含機架歧管層級) | 約150~350點(含冷板進出口) |
| 大型AI資料中心 | 200櫃以上 | 300點以上,需分區獨立監測架構 | 500點以上,通常需要分散式I/O架構 |
這個估算邏輯的核心概念是:機架數量每增加一個量級,儀表數量與系統複雜度並非線性增加,而是需要重新評估監測架構的分層設計(例如是否需要導入分散式I/O模組,或以區域控制器分區彙整訊號後再上傳至中央DCIM系統),這也是為什麼大型AI資料中心的儀表系統規劃,通常需要在專案初期就與儀表供應商深度討論架構設計,而非等到細部設計階段才臨時追加點位。
3.5 安裝位置與管路設計的實務注意事項
儀表選型正確,不代表安裝到位就能得到可信賴的數據。以下是幾個在AI資料中心液冷專案現場最常被忽略、卻直接影響量測準確度的安裝細節:
避免感測器裝在氣泡容易堆積的位置
液冷系統在初次充填或維護後,管路內難免殘留微量空氣。壓力與溫度感測器若安裝在管路頂部的死角區域,容易受困氣泡影響讀值穩定性,特別是壓力讀值會出現不合理的波動或偏低現象。建議感測器安裝點盡量選在管路側面或底部,並在系統設計時規劃排氣閥於管路最高點,定期排氣維護。
感測器插入深度與熱傳導路徑
溫度感測器若安裝在流速較慢的管路死角,或插入深度不足導致感測元件未能充分接觸主要流體,會造成量測值與實際流體溫度存在明顯落差,這種誤差通常不會立即被發現,卻會長期扭曲能效計算的準確性。建議溫度感測器安裝時,插入深度應達到管徑的三分之一至二分之一,並盡量避開流速死角區域。
隔離閥與維護窗口的預留設計
高可用性要求的機房,儀表安裝時應預留雙隔離閥岐管(Manifold Valve),讓感測器可以在不影響系統運作的情況下進行更換或校正。這在專案初期的管路設計階段就必須納入考量,事後加裝往往需要局部停機,對已上線的AI訓練叢集而言,任何非必要的停機都意味著昂貴的算力損失。
震動與機械應力的隔離
CDU內建幫浦運轉會產生持續性震動,長期下來可能影響鄰近感測器的機械穩定性與連接件的密封性。建議在振動源附近的感測器安裝點,加裝可撓性接管或減震固定座,避免震動直接傳導至感測元件,延長儀表的使用壽命並維持量測穩定性。
3.6 校正週期與長期維護規劃
儀表的校正週期規劃,應該依照監測點的重要性與環境嚴苛程度分級管理,而非一律套用固定週期:
| 監測點類型 | 建議校正週期 | 校正方式 |
|---|---|---|
| 能效計算基準點(CDU進出口溫度、壓力) | 每年一次 | 離線送實驗室校正,確保可追溯性 |
| 安全連鎖保護點(緊急停機連動) | 每半年一次 | 現場功能測試搭配定期送校 |
| 機架層級一般監測點 | 每一至兩年一次 | 抽樣校正,異常時全面複檢 |
| 可攜式診斷工具 | 每年一次 | 使用前建議快速比對驗證 |
此外,建議建立每個監測點的長期趨勢資料庫,即使尚未到校正週期,也能透過比對同類型感測器的讀值差異,及早發現異常漂移的個別感測器。這種「以數據驅動校正決策」的做法,比單純依賴固定週期更能有效掌握系統的實際健康狀態,也更符合AI資料中心對預防性維護的高標準要求。實務上建議由儀表供應商協助建立完整的校正履歷管理制度,將每支感測器的安裝日期、校正紀錄、更換歷史統一歸檔,這對於未來系統擴充時進行設備盤點、或發生異常事件需要追溯特定感測器履歷時,都能大幅縮短排查所需的時間。
第四章:ATLANTIS昶特推薦方案與產品完整解析
昶特有限公司(ATLANTIS)深耕工業儀錶製造31年,長期為半導體廠務、精密製造、能源產業提供壓力與溫度量測解決方案。面對AI資料中心液冷系統這個新興但要求極高的應用領域,昶特將既有的防爆設計、高精度傳感技術與HART智慧通訊能力,延伸應用到CDU迴路、機架歧管與環境監測等關鍵節點。與傳統工業應用不同的是,AI資料中心客戶通常對交期與現場技術支援的反應速度有更高的期待——畢竟液冷系統一旦上線,任何非計畫性的停機都可能直接影響訓練任務的進度,因此昶特在服務這類客戶時,特別強調現貨庫存管理與快速到貨能力,確保關鍵備品能在最短時間內送達現場。以下依照系統區域,介紹幾款適合導入AI資料中心的產品。
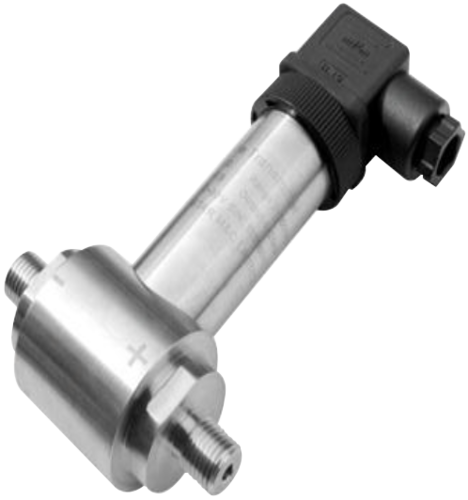
圖:ATLANTIS DPTX 防爆差壓傳送器 — 適用於過濾器前後差壓監測與CDU迴路壓差診斷
DPTX|防爆差壓傳送器
量程覆蓋範圍廣,陶瓷隔膜設計搭配316不鏽鋼或鋁合金殼體可選,雙針或單針指示配置可依現場需求彈性搭配。DPTX特別適合裝設於液冷系統精密過濾器前後,透過持續監測差壓值的變化趨勢,及早掌握濾網阻塞狀況,在流量明顯下降、影響下游機架散熱能力之前完成更換。RS-485通訊介面便於整合進機架層級的監測匯流排。
建議應用位置:CDU精密過濾器前後、機架歧管差壓診斷、二次側迴路阻力監測
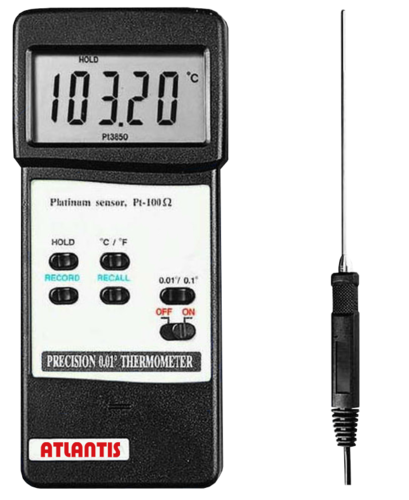
圖:ATLANTIS RTD-907A 白金電阻溫度計 — 工業級Pt100/Pt1000精密溫度感測
RTD-907A|白金電阻溫度計
採用工業級Pt100/Pt1000白金電阻測溫元件,精度等級可達A級規格,響應速度快,適合安裝於M20不鏽鋼保護管中,用於CDU出水溫度、機架歧管回水溫度等需要長期穩定性的監測點。4線制配線設計可消除引線電阻對量測精度的影響,這在長距離配線的大型資料中心機房中特別重要——避免因為配線壓降造成的溫度讀值偏移。
建議應用位置:CDU一次側/二次側出水溫度、機架歧管溫度監測、能效計算基準點

圖:ATLANTIS DPG-X112 高精度藍芽數位壓力錶 — 可旋轉330°面板設計,支援藍芽診斷
DPG-X112|高精度藍芽數位壓力錶
大屏LCD顯示設計,面板可旋轉330°方便機架密集安裝環境下的現場讀值,支援4-20mA/0-10V類比輸出,可選配HART通訊介面。DPG-X112特別適合裝設於機架歧管供液側與回液側,用於快速比對各機架之間的壓力分配是否均勻——這是判斷CDU二次側流量分配系統是否需要調校的重要依據。藍芽功能讓維護人員可用行動裝置直接讀取歷史趨勢,減少現場巡檢時間。
建議應用位置:機架歧管供液/回液壓力監測、快速巡檢診斷點

圖:ATLANTIS AT-THM80 高精度工業溫濕度傳送器 — 壁掛型、風管型、分離型安裝方式
AT-THM80|高精度工業溫濕度傳送器
同時監測溫度與相對濕度,提供壁掛型、風管型與分離型三種安裝方式,可依機房佈局彈性選擇。在氣冷區域或液冷CDU設置的機電房中,溫濕度監測用於確保環境條件不會導致結露風險(尤其是冷卻液管路表面溫度低於露點時,容易在金屬表面凝結水珠,長期恐造成電氣元件腐蝕或短路風險)。
建議應用位置:CDU機房環境監測、機架冷通道/熱通道溫濕度巡檢、結露風險預警
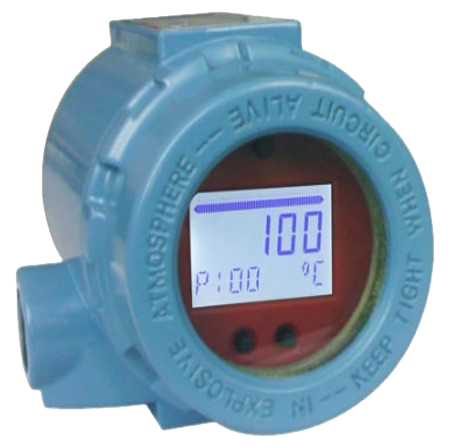
圖:ATLANTIS STT HART智能型溫度傳送器 — 一體化設計,支援Pt100與熱電偶輸入
STT|HART智能型溫度傳送器
一體化設計整合感測元件與訊號轉換電路,支援Pt100與熱電偶多種輸入類型,具備HART通訊能力可提供遠端診斷與參數校正功能,減少現場人員暴露於機房高密度環境的巡檢頻率。適合用於CDU出水溫度這類需要長期穩定運作、且維護時需盡量減少停機時間的關鍵監測點。
建議應用位置:CDU出水溫度遠端監控、需要HART診斷功能的關鍵溫度點

圖:ATLANTIS DMPG-X022 數位微差壓錶 — 原裝進口微差壓傳感器,超低功耗設計
DMPG-X022|數位微差壓錶
專為精密差壓測量設計,特別適合氣冷區域高效濾網(HEPA)前後的微壓監測,以及部分需要維持機房正壓/負壓環境的精密機房。超低功耗設計讓長期連續監測的維護成本大幅降低,穩定的微壓讀值有助於確保機房潔淨度與氣流控制的一致性。
建議應用位置:高效濾網前後差壓、機房正負壓監控、精密空調系統診斷

圖:ATLANTIS TDL-R/D-6C 可攜式螢幕觸控溫度紀錄器 — 六組通道型,觸控螢幕操作
TDL-R/D-6C|可攜式螢幕觸控溫度紀錄器(六組通道型)
可同步記錄六個測點的溫度數據,2.83吋TFT觸控螢幕便於現場即時查看趨勢圖,每個通道可獨立設定警報門檻。這款產品非常適合用於AI機房液冷系統的驗收測試與故障診斷階段——例如新機架上線前的多點溫度均勻性驗證,或懷疑某台伺服器冷板存在局部熱點問題時,可快速部署多點監測並記錄完整趨勢,作為根因分析的第一手數據。
建議應用位置:新機架上線驗收測試、故障診斷多點溫度追蹤、定期巡檢數據記錄

圖:ATLANTIS AT25 流量開關 — 靈敏度可調,IP67防水密封設計
AT25|流量開關(差壓型)
靈敏度可調的小型差壓開關,IP67防水密封設計,無需外接電源即可運作,特別適合作為機架歧管或關鍵分支迴路的流量喪失緊急保護訊號來源。當差壓訊號顯示流量異常中斷時,可直接連動至CDU控制系統觸發降載或緊急停機保護,避免GPU在無冷卻液流動的狀態下持續運作造成永久性損壞。
建議應用位置:機架分支迴路流量喪失保護、過濾器堵塞預警、自動化故障提示
4.1 基礎配置與進階配置方案對照
依照專案預算與可靠度需求的不同,昶特將AI資料中心液冷儀表方案,區分為基礎配置與進階配置兩種常見組合,供工程師在規劃初期快速掌握差異:
| 項目 | 基礎配置方案 | 進階配置方案 |
|---|---|---|
| 壓力監測範圍 | 僅CDU一次側/二次側進出口 | 延伸至每個機架歧管供液/回液側 |
| 溫度監測範圍 | CDU進出口溫度 | CDU進出口+機架歧管+關鍵冷板進出口 |
| 通訊介面 | 4-20mA類比訊號為主 | HART/Modbus整合,支援遠端診斷 |
| 差壓監測 | 無獨立差壓監測 | 精密過濾器前後裝設差壓傳送器並接入趨勢警報 |
| 資料記錄 | 即時顯示,無長期歷史記錄 | 90天以上歷史資料保存,支援事件觸發高頻記錄 |
| 適合場景 | 中小型推論叢集、預算有限的先導專案 | 大型訓練機房、高可用性要求、企業級SLA承諾 |
多數客戶會採取分階段導入策略:先以基礎配置完成關鍵節點覆蓋,確保系統上線初期具備基本的安全保護能力,再依實際營運需求與預算規劃,逐步擴充至進階配置,將機架層級的監測密度提升,並強化資料記錄與遠端診斷能力。這種漸進式的導入方式,能有效分攤初期建置成本,同時保留未來擴充的彈性。
4.2 為什麼選擇ATLANTIS作為AI資料中心儀表供應商
AI資料中心的液冷系統仍是快速演進中的新興應用領域,這代表儀表供應商的選型諮詢能力與快速交期往往比單一產品規格更重要。昶特ATLANTIS長期服務半導體廠務、精密製造與能源產業,累積了大量在高密度、高可靠度要求環境下的儀表選型經驗,能夠針對客戶的實際冷卻液種類、迴路配置、通訊架構,提供對應的規格建議,而非僅是銷售標準型號。
此外,昶特作為台灣本地製造商,在AI資料中心這類專案時程壓力極大的建置案中,具備比進口品牌更靈活的客製化與快速交期優勢,同時提供完整的校正與技術支援服務,確保系統上線後的長期穩定運作。
4.3 從規劃到上線:昶特的專案協作流程
AI資料中心的儀表導入,並非單純的產品採購行為,而是需要與機電統包商、CDU設備商、IT維運團隊多方協作的系統工程。昶特應用工程團隊在服務此類專案時,通常依循以下協作流程,協助客戶降低選型錯誤與工期延誤的風險:
- 需求訪談與現場勘查:了解冷卻液種類、系統設計壓力與溫度範圍、既有BMS/DCIM系統的通訊介面需求,必要時安排現場勘查確認安裝環境條件。
- 規格書與點位表製作:依照本文第三章的完整儀表清單邏輯,協助客戶製作符合實際專案需求的採購規格書與監測點位表,明確每個測點的精度、通訊介面與安裝方式要求。
- 樣品驗證與小批量測試:對於較大型或客製化程度較高的專案,建議先以樣品進行小批量現場測試,確認儀表在實際運作環境下的穩定性,再進行全面採購。
- 安裝技術支援與教育訓練:提供現場安裝技術指導,並針對維運團隊進行儀表操作與基本故障排除的教育訓練,確保系統上線後維運團隊具備自主排查能力。
- 長期校正與備品服務:提供後續的定期校正提醒服務與備品供應,避免因單一感測器故障而影響整體監測系統的完整性。
第五章:真實案例研究與投資回報分析
5.1 案例背景:北台灣某AI運算中心液冷機房升級案
本案例主角為北台灣一座提供AI訓練與推論服務的資料中心(因客戶保密協議,以下不揭露公司名稱),原本以氣冷方式支援機架功率密度約15 kW的運算叢集。隨著客戶需求轉向大型語言模型訓練,機房陸續導入單顆TDP超過600瓦的GPU伺服器,機架功率密度規劃提升至50 kW以上,原有氣冷架構已無法負荷,因此於2026年上半年啟動D2C冷板式液冷系統改造專案。
5.2 升級前遭遇的問題
在改造專案初期的系統測試階段,該機房遭遇了幾個具體的痛點:
- 壓力監測盲區:初期設計僅在CDU主機本體內建了基本壓力顯示,機架歧管層級完全沒有獨立監測,導致當某一機架的供液分支出現輕微阻塞時,維運團隊完全無法從監控畫面察覺,直到該機架的GPU開始出現溫度過高警報才後知後覺。
- 溫度感測器響應速度不足:原始設計採用的溫度感測器響應時間偏慢,在GPU負載快速切換的訓練任務中,量測到的溫度值明顯落後於實際晶片溫度變化,導致控制系統的降載保護動作觸發過晚。
- 缺乏差壓趨勢記錄:過濾器堵塞完全依賴人工定期目視檢查濾網狀況,缺乏客觀數據支持更換週期的決策,曾發生過濾器已嚴重阻塞但仍未達到人工檢查排程的情況,造成局部機架流量不足。
5.3 導入的解決方案
經過昶特應用工程團隊現場勘查與需求訪談後,該機房分階段導入以下監測方案:
| 階段 | 導入內容 | 解決的問題 |
|---|---|---|
| 第一階段 | CDU一次側/二次側裝設高精度壓力傳送器與白金電阻溫度計,取代原廠內建的基本顯示 | 提升設施層監測精度與HART遠端診斷能力 |
| 第二階段 | 每個機架歧管供液/回液側裝設數位壓力錶,建立機架層級壓力地圖 | 消除壓力監測盲區,可即時比對各機架壓力分配均勻性 |
| 第三階段 | 精密過濾器前後裝設差壓傳送器,串接至監控系統建立趨勢警報 | 將濾網更換從「定期排程」轉為「數據驅動」的預防性維護 |
| 第四階段 | 導入可攜式多點溫度記錄器,用於新機架上線前的驗收測試 | 在問題影響正式營運前,於測試階段就發現異常機架 |
5.4 導入後的量化成效
完整導入監測方案並穩定運作六個月後,該資料中心統計了升級前後的比較數據:
| 指標 | 升級前 | 升級後 | 改善幅度 |
|---|---|---|---|
| 機架層級異常發現時間 | 平均數小時(依賴GPU溫度警報後才察覺) | 平均數分鐘(壓力趨勢異常即時觸發預警) | 大幅縮短 |
| 過濾器更換方式 | 固定週期人工排程,曾發生過度堵塞情況 | 依差壓趨勢數據驅動,精準掌握更換時機 | 維護效率顯著提升 |
| 因散熱異常導致的GPU降頻事件 | 每月數起 | 降至偶發個案 | 顯著下降 |
| 現場人工巡檢頻率 | 每日多次人工目視巡檢 | 遠端監控為主,現場巡檢頻率降低 | 人力成本下降 |
5.5 投資回報分析框架
對於評估是否要投資完整的壓力與溫度監測系統,建議從以下幾個面向建立投資回報分析框架,而非僅比較儀表本身的採購成本:
直接成本節省
- 減少因流量不足或熱點未及時發現造成的GPU降頻,避免運算資源浪費(AI算力的機會成本極高,即使是短時間的降頻,換算成運算資源損失也相當可觀)
- 過濾器等耗材從固定週期更換轉為數據驅動更換,避免過早更換造成的耗材浪費,或過晚更換造成的流量損失
- 降低現場人工巡檢頻率,減少人力工時成本
風險規避價值
- 及早發現漏液風險,避免冷卻液滲入電氣元件造成的設備損壞與停機損失
- 避免因汽蝕或壓力異常長期未被發現,導致幫浦、閥門等關鍵元件的加速磨損與提前更換
- 降低因熱管理失效導致的GPU永久性損壞風險——這類損壞的更換成本與交期延誤成本,遠高於監測系統本身的投資
營運效率提升
- 完整的壓力溫度歷史數據,有助於未來機架擴充時進行更精準的容量規劃
- 遠端診斷能力(HART、Modbus)降低對現場人力的依賴,特別適合分散式或無人值守機房的營運模式
在實務上,建議將這套投資回報分析框架,作為與內部財務或管理層溝通監測系統預算的工具,而不只是單純呈現儀表本身的採購金額。將風險規避價值與營運效率提升具體量化(即使只是提供合理範圍的估算),往往能讓決策者更清楚理解,這筆投資實際上是在保護一項規模遠大於監測系統本身的資產——也就是整座機房的GPU運算能力與其創造的營運價值。
5.6 案例二:桃園地區AI推論資料中心的濾網阻塞事件與後續改善
第二個案例來自桃園地區一座主要提供AI推論服務的中型資料中心,機房採用D2C冷板式液冷架構,機架功率密度約35 kW。此案例的重點不在於系統升級,而是一次實際發生的異常事件,以及事件後如何透過儀表數據強化預防性維護機制。
事件經過:某次例行檢查中,維運人員發現特定機架區塊的GPU溫度較同批次其他機架偏高約8°C,但尚未觸發GPU本身的降頻保護門檻。透過查閱該機架歧管的壓力歷史趨勢數據,發現供液壓力在過去三週內呈現緩慢但持續的下降趨勢,降幅約12%。進一步排查後確認,是CDU二次側精密過濾器因初期安裝時管路內殘留的微量焊渣,經過數週運作逐漸堆積阻塞,導致流向該機架區塊的分支流量受到影響。
關鍵發現:由於該機房已在CDU出口與過濾器前後裝設差壓傳送器並接入監控系統,維運團隊得以在GPU尚未觸發降頻保護、尚未造成任何算力損失之前,就透過壓力趨勢數據主動排查並更換過濾器,整個排查到更換的過程在系統不停機的狀態下於數小時內完成。若沒有這套壓力趨勢監測機制,這起事件很可能會持續發展至流量嚴重不足、GPU開始頻繁降頻甚至觸發熱保護關機,才會被動地被發現。
後續改善措施:該資料中心在此事件後,將過濾器差壓的預警門檻從單一固定值,改為「相對於安裝初始值的百分比變化率」動態門檻設計,並將所有機架歧管的壓力趨勢數據納入每週例行檢視報告,把原本被動的故障排除,轉型為主動的預防性維護流程。這個案例具體說明了,即使沒有發生嚴重的營運中斷,完整的壓力監測數據本身,就已經能在異常影響擴大之前提供決定性的預警價值。
第六章:20個工程師必問FAQ
以下彙整昶特應用工程團隊在實際服務AI資料中心客戶過程中,最常被問到的20個問題,涵蓋選型邏輯、安裝細節、校正週期與系統整合等面向,希望能為正在規劃或維運液冷機房的工程師,提供快速可查閱的實戰參考。
❓ Q1:AI資料中心液冷系統,壓力與溫度到底哪個訊號比較重要?
兩者同等重要,而且應該被視為一組互相驗證的訊號,而非各自獨立的監測項目。壓力異常通常先於溫度異常發生——例如過濾器堵塞會先反映在差壓上升,經過一段時間後才會因流量不足導致溫度異常。如果只監測溫度,往往會錯失壓力訊號提供的早期預警時間。建議在關鍵節點同時部署壓力與溫度感測器,並在監控系統中設定交叉比對邏輯。
❓ Q2:CDU本身通常已內建壓力顯示,為什麼還需要額外加裝獨立的壓力錶?
CDU內建的壓力顯示多半僅監測CDU本體進出口,無法反映機架歧管層級以下的壓力分配狀況。當某一機架的供液分支發生局部阻塞或壓力偏移時,CDU本體讀值可能完全正常,因為問題發生在CDU下游。獨立部署機架層級的壓力監測,才能建立完整的壓力地圖,及早發現分支迴路的異常。
❓ Q3:兩相浸沒式液冷系統的壓力監測,跟D2C冷板式有什麼不同?
兩相浸沒式系統的壓力監測重點在於維持槽體內部接近大氣壓的密閉環境,壓力異常升高通常代表冷凝效率不足或蒸氣外洩風險增加。這類系統需要更頻繁、更高精度的壓力監測,且通常需要搭配絕對壓力量測(而非僅相對壓力),因為系統運作原理仰賴精確的相變化平衡。
❓ Q4:溫度感測器裝在冷板出口,會不會影響GPU散熱效能?
選用適當尺寸與安裝方式的微型溫度感測器,對流體阻力的影響極小,可忽略不計。關鍵在於選用響應速度快、體積小的感測元件,並確保感測器的安裝方式不會造成局部流道截面積的明顯縮減。這部分建議在系統設計初期就與冷板供應商協調安裝介面規格。
❓ Q5:差壓傳送器裝在過濾器前後,多久需要校正一次?
用於預防性維護判斷的差壓傳送器,建議每年校正一次;若該監測點同時連動至安全連鎖保護動作(例如觸發緊急停機),建議縮短至每半年校正一次,確保保護動作的可靠性。實際校正週期也應參考感測元件的長期穩定性規格與現場運作環境的嚴苛程度。
❓ Q6:4-20mA類比訊號跟HART通訊,AI機房應該選哪一種?
建議採用HART通訊,因為它在既有4-20mA基礎設施上疊加數位診斷資訊,除了製程變數外還能取得感測器健康狀態、零點漂移等診斷資料,有助於預防性維護。對於機架層級點位數量龐大的場景,也可考慮Modbus RTU匯流排架構降低配線成本。
❓ Q7:為什麼AI機房的壓力感測器要特別強調「響應速度」?
因為AI訓練負載的功率抖動週期可能短至數百毫秒,傳統機械式波登管結構的響應速度無法捕捉這類瞬態事件。建議選用響應時間在毫秒等級的擴散矽或陶瓷電容式感測元件,搭配高頻率採樣的資料記錄功能,才能完整還原異常事件發生時的波形,用於事後故障分析。
❓ Q8:冷卻液選用去離子水,儀表選型需要特別注意什麼?
去離子水的電導度極低,需要特別注意接液部件避免使用會與去離子水產生離子交換或電化學腐蝕的材質,建議優先選用316L不鏽鋼或PEEK材質的隔膜與接液元件,並避免不同金屬材質直接接觸產生的電偶腐蝕風險。
❓ Q9:機架歧管的壓力錶,該選指針式還是數位式?
建議選用數位式,主要原因是機架密度極高的環境下,指針式壓力錶的目視巡檢效率低,且無法提供連續的歷史趨勢數據。數位式壓力錶除了可本地顯示,還能透過4-20mA或HART輸出訊號至監控系統,實現遠端連續監測,這對需要建立完整壓力地圖的AI機房而言是必要功能。
❓ Q10:溫度感測器的Pt100跟熱電偶,AI機房液冷系統該選哪個?
在AI機房液冷系統的溫度範圍(通常在15~60°C之間),Pt100白金電阻溫度計的精度與穩定性明顯優於熱電偶,且不需要冷接點補償,是液冷系統溫度監測的主流選擇。熱電偶則更適合用於需要量測極高溫度範圍的應用,在資料中心液冷場景中較少採用。
❓ Q11:新機架上線前,需要做哪些壓力溫度相關的驗收測試?
建議至少進行以下三項測試:一是靜態壓力測試,確認各連接點無洩漏且壓力值符合設計規格;二是多點溫度均勻性測試,使用可攜式多通道溫度記錄器同步監測多個冷板進出口,確認流量分配是否均勻;三是動態負載測試,在模擬滿載狀態下觀察壓力與溫度的響應曲線,確認系統在尖峰負荷下的穩定性。
❓ Q12:補液系統的壓力監測,跟系統洩漏偵測有什麼關係?
液冷系統不可能做到零洩漏,密封件的微量滲漏是長期存在的現實。補液系統的壓力與液位監測,本質上是在間接偵測整個系統的洩漏速率——當補液頻率異常增加,代表系統某處可能存在緩慢但持續的洩漏,需要透過壓力數據的長期趨勢分析及早發現,而非等到液位嚴重不足才處理。
❓ Q13:機房環境的溫濕度監測,跟液冷系統的溫度監測是同一回事嗎?
不是。液冷系統溫度監測針對的是冷卻液本身的溫度,反映散熱效能;機房環境溫濕度監測則是針對周遭空氣環境,主要目的是預防結露風險(當管路表面溫度低於環境露點溫度時,容易在金屬表面凝結水珠,長期可能造成電氣元件腐蝕)以及確保氣冷區域的環境條件符合設備運作規範。兩者監測目的不同,需要分別規劃。
❓ Q14:壓力感測器的量程應該怎麼選?系統設計壓力是3 bar,該選多大量程?
依照業界普遍採用的黃金法則,建議選擇工作壓力的1.5~2倍作為量程上限。以設計壓力3 bar為例,選用量程4~6 bar的感測器較為合適,這樣既能保留足夠的過壓安全裕度,又能確保在正常工作範圍內有良好的解析度,避免量程過大導致的讀值精度不足。
❓ Q15:AI機房液冷系統的儀表,需要考慮防爆認證嗎?
一般而言,資料中心機房環境本身不屬於易燃易爆區域,因此標準型儀表即可滿足大多數需求。但如果機房緊鄰柴油發電機房、燃料儲存區,或位於特殊工業區內有法規要求,則需要評估該區域的防爆分區等級,選用對應認證的儀表。建議在專案初期與消防、機電技師確認機房的區域分類。
❓ Q16:多點溫度記錄器跟固定式溫度傳送器,AI機房應該怎麼分配使用?
建議採取「固定式監測關鍵常設點位,可攜式用於診斷與驗收」的策略。CDU出水溫度、機架歧管溫度這類需要長期連續監測的關鍵點位,應採用固定式溫度傳送器並接入監控系統;而新機架上線驗收、故障診斷追蹤這類臨時性、多點同步的測試需求,則適合使用可攜式多通道溫度記錄器,靈活部署且不需要永久配線。
❓ Q17:差壓開關跟差壓傳送器,在快接頭漏液偵測上該選哪個?
如果只需要「是/否」的二元判斷(例如壓力驟降超過設定門檻立即觸發保護動作),差壓開關的成本效益較高,且可直接硬體連動至緊急關斷閥。如果需要持續監測壓力趨勢變化、進行預防性分析,則需要差壓傳送器提供連續類比訊號。許多實務案例會同時部署兩者:傳送器負責趨勢監測與預警,開關負責最後一道緊急保護。
❓ Q18:儀表的材質證明書(Material Certificate)對AI資料中心專案重要嗎?
相當重要,尤其對於大型企業級資料中心專案或有國際客戶要求可追溯性的案場。材質證明書記錄鋼號、熱處理記錄、第三方檢驗報告,一旦發生異常需要根因分析時,能夠快速追溯到具體的製造批次,這對於保固責任釐清與品質管理都有實質幫助。建議在採購規格書中明確要求供應商提供材質合格證。
❓ Q19:既有氣冷機房要改造為液冷,儀表系統可以沿用嗎?
氣冷系統原有的溫濕度傳送器、風壓監測儀表,在改造後的機房環境監測中仍可繼續使用;但液冷迴路本身(CDU、機架歧管、冷板)屬於全新的監測需求,無法沿用氣冷系統的儀表,需要依照本文第三章的完整儀表清單重新規劃選型與安裝。
❓ Q20:導入完整壓力溫度監測系統後,還需要人工巡檢嗎?
需要,但頻率與目的會改變。完整的自動化監測系統能大幅降低人工巡檢的頻率與急迫性(不再需要依賴人工目視發現異常),但定期的現場巡檢仍有其價值,例如目視確認管路外觀狀況、接頭是否有結露或滲漏痕跡、感測器安裝是否穩固等,這些是自動化監測系統較難完全取代的檢查項目。建議將人工巡檢頻率從「高頻率被動排查」轉型為「低頻率主動確認」。
第七章:延伸閱讀與相關技術資源
若您正在規劃AI資料中心的液冷系統儀表選型,以下技術資源提供更深入的延伸閱讀:
此外,昶特也提供多款免費的線上選型精靈工具,協助工程師快速篩選符合需求的儀表規格,包括壓力錶選型精靈、溫度計選型精靈與差壓/微差壓選型精靈,歡迎在規劃初期階段多加利用,快速釐清規格方向。
7.1 從其他產業的儀表應用經驗,看AI機房監測的共通邏輯
值得一提的是,AI資料中心液冷系統面對的許多挑戰,其實與昶特長期服務的半導體廠務、精密製造、能源產業有高度共通之處。例如半導體無塵室對微差壓的精密控制需求,與AI機房高效濾網的差壓監測邏輯相通;石化業防爆壓力傳送器的高可靠度設計要求,也對應到AI機房對關鍵監測點零故障的期待;而製藥產業對溫度數據可追溯性的嚴格規範,同樣適用於AI資料中心對能效數據稽核的需求。這也是為什麼昶特能夠將31年累積的跨產業精密量測經驗,快速轉譯應用到AI資料中心這個相對新興的應用領域,而不是從零開始摸索。
建議工程師在規劃AI機房儀表系統時,不妨也參考上述傳統高可靠度產業的既有實務——包括材質相容性驗證流程、多重感測器表決邏輯、以及以數據驅動而非固定週期的校正策略,這些都是歷經數十年工業實踐驗證過的方法論,直接應用在新興的AI資料中心液冷場景中,往往能少走許多彎路。
產業趨勢展望:液冷監測系統的下一步演進
隨著GPU功耗持續攀升、機架密度不斷刷新紀錄,AI資料中心的液冷監測系統也正朝幾個方向快速演進,這些趨勢值得工程師在規劃新專案時提前納入考量:
從單點監測走向系統級數位分身(Digital Twin)
越來越多大型資料中心開始將壓力與溫度數據,整合進系統級的數位分身模型中,透過即時數據驅動的模擬,預測特定負載情境下各機架的散熱表現,而不只是被動監測異常。這對儀表系統提出了更高的資料品質要求——數據不再只是用於警報判斷,更是模擬模型的輸入來源,任何量測誤差都會被放大反映在預測結果的準確度上。
邊緣運算節點的液冷監測需求崛起
隨著AI推論應用逐漸從中心化的大型資料中心,擴展至更靠近使用者的邊緣運算節點,小型化、模組化的液冷系統也開始出現在傳統機房環境之外的場域(如電信機房、工廠端運算節點)。這類場域通常缺乏專職的機電維運人員,對儀表系統的「免維護」與「遠端診斷」能力要求更高,也是儀表供應商未來需要因應的新興應用場景。
永續發展要求下的能效數據精確度需求
隨著資料中心產業面臨越來越嚴格的能效與碳排放揭露要求,PUE、WUE等關鍵指標的計算精確度,直接關係到企業的永續報告可信度。這代表用於能效計算的溫度與流量相關量測點,其精度要求只會越來越高,過去被視為「堪用即可」的監測方案,未來可能無法滿足法規揭露或客戶稽核的要求。
結論:AI資料中心的可靠度,藏在每一個壓力與溫度讀值裡
AI資料中心的競爭,表面上是算力密度與能源效率的競爭,但真正決定系統能否穩定運作的底層邏輯,其實是液冷迴路裡每一個壓力與溫度讀值是否被正確監測、正確解讀。從CDU一次側到機架歧管、從冷板進出口到補液系統,壓力錶與溫度計不是機電系統的配角,而是唯一能在異常發生的第一時間,把看不見的流體狀態轉化為可以決策的數字的關鍵元件。
本文從系統架構、負載特性、選型清單到真實案例,完整拆解了AI資料中心為什麼需要一套經過精心規劃的壓力與溫度監測系統,而不是沿用傳統工業應用的標準做法。無論您正在規劃全新的液冷機房,或是評估既有氣冷機房的升級改造,一套完整的儀表監測地圖,都是確保GPU投資不被熱管理失效吞噬的最後一道防線。
昶特ATLANTIS以31年工業儀錶製造經驗,結合半導體廠務、精密製造領域累積的高可靠度量測技術,為AI資料中心液冷系統提供從壓力傳送器、溫度傳送器到差壓監測的完整解決方案。我們的應用工程團隊了解每一種冷卻液架構的特殊需求,能夠針對您的專案提供實際可執行的選型建議,而非制式化的產品目錄推銷。
回到文章開頭的提問:AI資料中心為什麼需要壓力錶與溫度計?答案很簡單——因為在液冷系統裡,壓力與溫度是唯二能夠即時、客觀、可量化地告訴你「系統現在是否安全」的訊號來源。GPU本身的溫度警報永遠是「果」,而壓力與溫度的趨勢變化才是能夠捕捉到「因」的關鍵線索。少了這兩組數據,再先進的AI算力,也只是建立在一套看不見、猜不透的散熱系統之上,隨時可能因為一次未被及時發現的異常,付出遠超過儀表投資本身的慘痛代價。與其等到GPU降頻、伺服器跳機才被動因應,不如從系統規劃的第一天,就把壓力錶與溫度計放在它們該在的位置。
聯絡ATLANTIS昶特應用工程團隊
📞 業務一部 Ian|電話:02-2820-3405|信箱:ian@atlantis.com.tw
📞 業務二部 Nori|電話:02-2820-3405|信箱:nori@atlantis.com.tw
昶特有限公司|台北市北投區致遠一路二段109號
傳真:02-2827-0646 / 02-2820-3406|公司官網:re-atlantis.tw
🎯 立即行動:為您的AI資料中心規劃專屬儀表方案
無論您是機電統包商、資料中心設施工程師,或液冷系統整合商,昶特都能協助您依照專案需求,規劃出兼顧可靠度與成本效益的壓力溫度監測方案。