壓力/溫度感測 → Edge → AI → SCADA/BMS:預測性維護資料骨幹完整建置指南(2026版)
「機台又停機了,這次是軸承還是感測器線路的問題?」——如果這句話你聽過不只一次,代表工廠或機房裡的異常,仍然是事後才發現,而不是提前被預測。過去十年,「預測性維護」幾乎已經變成每一場智慧製造研討會的關鍵字,但根據國際市調機構最新資料,全球僅約 27% 的製造業者真正導入預測性維護,另有高達 65% 的維護團隊有意導入 AI 預測技術,實際落地的卻不到三分之一。缺口不在演算法,而在資料骨幹:從最底層的壓力與溫度感測,到 Edge 邊緣運算、AI 模型推論,再到 SCADA/BMS 監控系統的整合,任何一段斷鏈,預測性維護就只是一份漂亮的簡報。
本篇文章要拆解的,正是這條「壓力/溫度感測 → Edge → AI → SCADA/BMS → 預測維護」的完整資料路徑:感測器該怎麼選、訊號怎麼傳、Edge Gateway 怎麼部署、AI 異常偵測邏輯長什麼樣子、又該如何回饋進 SCADA 與 BMS 系統,形成一個真正會自己說話的資產健康監控網路。文章同時附上可參考的通訊程式範例(Modbus/RS-485、4-20mA 訊號讀取、Edge 端資料前處理),方便工程團隊自行串接——昶特 ATLANTIS 專注於提供高精度、高穩定度的壓力與溫度感測儀表本體,不承接 IoT 平台或雲端串接代工服務,因此文中程式碼皆為架構參考範例,實際串接仍需由貴公司的自動化/IT 團隊依現場系統客製調整。
非計畫性停機時間可降低幅度(導入預測性維護後)
AI 異常偵測平均提前預警天數(機電/暖通設備)
透過感測資料關聯分析可消除的無效警報比例
預測性維護專案常見投資報酬率區間
這些數字並非空談,而是來自工業物聯網(IIoT)與智慧建築產業近年累積的實測數據。但數字背後有一個共同前提:感測層的資料必須夠準、夠即時、夠穩定。壓力與溫度,是幾乎所有旋轉機械、流體系統、暖通空調(HVAC)與電力設備最基礎也最關鍵的兩個物理量——軸承過熱、幫浦空蝕、冷媒洩漏、管路阻塞、變壓器油壓異常,幾乎都會先反映在壓力或溫度的微小飄移上。如果感測層本身精度不足、訊號漂移、校正週期混亂,後端再強大的 AI 模型也只是在雜訊上做預測。
另一個常被忽略的現實是:預測性維護專案的失敗,很少是因為 AI 模型不夠聰明,而是因為組織內部的斷層——維護團隊懂設備、不懂資料;IT 團隊懂系統整合、不懂製程;自動化工程師懂 PLC/SCADA、卻對雲端 AI 平台陌生。根據近年產業調查,導入預測性維護的三大障礙依序為:投資報酬率不易量化(約占 25%)、技術人才短缺(約占 24%,目前近七成維護專業人員年齡超過 50 歲)、以及 OT/IT 網路整合帶來的資安疑慮(約占 22%)。這也是為什麼本文特別強調「架構」而非單純「工具」——唯有把感測、Edge、AI、SCADA/BMS 四層的職責與介面定義清楚,才能讓跨部門團隊各自負責自己最擅長的一層,而不是把整個專案壓在單一團隊身上。
值得留意的是,就算是最先進的生成式 AI 與 Agentic AI(自主執行維護動作的 AI 系統)逐漸被導入到預測性維護場景,研究機構仍提醒:過於複雜、缺乏明確資料基礎的自主化專案,有相當高比例會因成本與複雜度問題而中止。換句話說,「先把感測層與資料骨幹打穩,再逐步疊加智慧化程度」,仍然是目前最務實、風險最低的導入順序——這也是本文接下來會依循的邏輯,也是我們在協助客戶規劃專案時,一再強調的優先順序。
接下來的章節,我們會依照「架構 → 數據 → 選型 → 方案 → 案例 → 常見問題」的順序,帶工程師、設施管理者與採購決策者,完整看懂這條資料骨幹該怎麼蓋:第一章拆解四層架構的技術細節與通訊協定選擇;第二章用量化數據說明尖峰負載與異常訊號的關聯;第三章提供依應用場景分類的儀表選型清單;第四章介紹昶特 ATLANTIS 可作為感測層起點的產品線;第五章以匿名案例呈現完整的 12 個月導入歷程與投資回收分析;第六章整理 20 個工程團隊最常提出的實務問題。
第一章:完整架構拆解——從物理量到決策動作
「壓力/溫度感測 → Edge → AI → SCADA/BMS → 預測維護」看似只有五個節點,但每一段都有工程師必須理解的技術細節與常見誤區。以下依序拆解四層架構,並說明每一層對整體預測準確率的影響。
1.1 感測層(Sensing Layer)——資料骨幹的地基
感測層決定了整條資料鏈的資料品質天花板。無論後端 AI 模型多先進,感測器本身若有以下任一問題,預測結果都會失真:這個道理在資料科學領域有一句經典的說法——「垃圾進、垃圾出」(Garbage In, Garbage Out),套用在預測性維護的情境下,意思是:如果最底層的壓力與溫度讀值本身就不準確、不穩定,那麼無論後端的 AI 模型演算法多麼先進、SCADA/BMS 整合介面多麼精美,最終產出的預測結果,都只是在忠實地放大感測層的缺陷而已。
- 精度不足:一般工業用壓力錶精度約 ±1.6% FS,若用於早期異常偵測(需捕捉 0.5% 以內的緩慢飄移),建議選用精度 ±0.5% FS 甚至 ±0.1% FS 的數位壓力傳送器。
- 取樣頻率過低:傳統機械式錶僅供人工巡檢讀值,無法連續取樣;若要做趨勢分析與早期預警,至少需要每 1–10 秒一筆的連續數位輸出。
- 訊號雜訊與飄移:類比 4-20mA 訊號若配線過長、接地不良,容易產生雜訊;建議搭配 HART 通訊疊加數位診斷資訊,或直接採用 RS-485 Modbus 數位輸出。
- 環境耐受性不足:戶外、防爆區、高溫爐體旁的感測器,若未達對應防護等級(IP66/IP67、ATEX/防爆認證),故障率會顯著提高,反而製造更多「假異常」。
| 感測面向 | 一般巡檢型儀表 | 預測性維護建議規格 |
|---|---|---|
| 壓力精度 | ±1.6% FS(指針錶) | ±0.5%~±0.1% FS(數位/智慧型傳送器) |
| 溫度精度 | ±1°C~±2°C(一般雙金屬溫度計) | ±0.1°C~±0.3°C(PT100 白金電阻溫度計) |
| 輸出訊號 | 純指針顯示,無輸出 | 4-20mA / HART / RS-485 Modbus / 藍牙數位輸出 |
| 取樣頻率 | 人工巡檢,每日 1~3 次 | 連續取樣,1~10 秒/筆 |
| 防護等級 | IP54 或無標示 | IP66/IP67,視現場需求加選防爆認證 |
| 資料可追溯性 | 紙本巡檢表,無電子紀錄 | 時間戳記 + 數位歷史資料,符合 ISO 17359 稽核要求 |
1.2 Edge 邊緣層——把原始訊號變成「有意義的事件」
Edge 層的角色,是在資料離開現場、進入雲端或中控室之前,先完成三件事:訊號正規化(單位轉換、Tag 命名統一)、時間同步(避免多感測點時間戳漂移造成誤判)、以及初步異常偵測(在毫秒等級延遲內做本地判斷,不必事事等雲端回應)。這也是為什麼近年 Edge AI 硬體(如工業級邊緣運算模組)能把單一機台的異常偵測從雲端的秒級延遲,壓縮到 15 毫秒以內的關鍵原因——對於需要即時連鎖保護(interlock)的高壓、高溫設備,這個差異就是「來得及停機」與「已經跳機」的分別。
從硬體規劃角度來看,Edge 層通常不是單一設備,而是一個小型的運算層級:入門等級可能僅是一台工業電腦搭配通訊模組,負責資料蒐集與正規化;進階配置則會加入具備 AI 加速能力的運算模組,處理較複雜的多感測融合模型;若場域規模夠大,也可能在同一廠區部署多台 Edge Gateway,分區負責不同產線或設備群組,再統一匯總至中控室層級。這種分層設計的好處是:單一 Edge Gateway 故障時,只會影響該區域的監控,不會讓整廠監控同時中斷,提升了系統的整體韌性。
Edge Gateway 常見部署型態:
- PLC/RTU 旁接式:Edge Gateway 透過 RS-485 或乙太網路,從既有 PLC/SCADA 讀取壓力、溫度暫存器,不干擾既有控制迴路。
- 感測器直讀式:具數位輸出(Modbus RTU、HART、藍牙)的智慧型壓力/溫度傳送器,直接由 Edge Gateway 輪詢讀取,適合既有系統沒有多餘 I/O 點位的場景。
- 混合式:關鍵設備走直讀式取得高頻資料,非關鍵區域沿用既有 SCADA 資料,兩者於 Edge 層統一格式後再上傳。
1.3 AI 分析層——從「數值」到「趨勢」再到「剩餘壽命」
預測性維護的 AI 模型,大致可分為三個成熟度層級。理解這三個層級的差異非常重要,因為它們對應的資料需求、開發時間與投入資源都截然不同,貿然跳過前期層級、直接追求最高階的剩餘壽命預測,往往會因為資料基礎不足而延宕專案時程:
| 層級 | 技術方法 | 可回答的問題 | 導入門檻 |
|---|---|---|---|
| Lv.1 閾值告警 | 固定上下限、標準差告警 | 「現在數值是否異常?」 | 低,SCADA 內建功能即可 |
| Lv.2 異常偵測 | 孤立森林、DBSCAN、統計製程管制(SPC) | 「這個模式是否偏離歷史常態?」 | 中,需 2~4 週基準資料 |
| Lv.3 預測與剩餘壽命 | LSTM/時序回歸、數位分身(Digital Twin) | 「還可以安全運轉多久?何時該排維修?」 | 高,需 6~12 個月歷史資料與 FMEA 對應 |
多數導入專案會從 Lv.2 異常偵測開始,原因是投報比最直接:透過壓力與溫度的多感測融合(Multimodal Sensor Fusion),同時比對多個訊號的相關性,可將誤報率大幅降低(業界實測案例可達 90% 以上的無效警報削減),讓維護團隊真正只在「值得看」的時候收到通知。以下提供一段 Edge 端異常偵測的邏輯範例,供工程團隊參考架構(僅為概念性虛擬碼,非可直接執行版本):
#(虛擬碼/概念範例)孤立森林異常偵測 — 壓力/溫度雙訊號
# 目的:示意 Edge 端如何以歷史基準資料判斷即時讀值是否異常
#
# 1. 蒐集 2~4 週的正常運轉基準資料 (pressure, temperature)
# 2. 以 IsolationForest 或同等演算法訓練基準模型
# 3. 每次新讀值進來時,計算異常分數並與門檻值比較
#
# from sklearn.ensemble import IsolationForest
#
# baseline = load_baseline_dataset()          # [[pressure, temperature], ...]
# model = IsolationForest(contamination=0.02)
# model.fit(baseline)
#
# def on_new_reading(pressure, temperature):
#     score = model.decision_function([[pressure, temperature]])
#     if score < THRESHOLD:
#         raise_local_alert(pressure, temperature, score)
#     forward_to_scada(pressure, temperature, score)
實務上,這類模型通常部署在 Edge Gateway 或工業電腦上,僅將「事件」(異常分數、告警旗標)而非全部原始波形上傳至雲端或中控室,藉此節省頻寬並降低雲端運算成本。
1.4 SCADA/BMS 整合層——讓 AI 判斷變成可執行的維護動作
再精準的 AI 預測,如果沒有回饋進現場真正在用的監控系統,維護人員終究不會天天盯著另一個獨立平台看。因此整合層的設計原則是:不取代既有 SCADA/BMS,而是把 AI 產出的異常事件、健康分數、預測結果,以標準通訊協定寫回既有系統的標籤(Tag)或警報清單。
這個原則背後的邏輯很直接:維護人員已經習慣在既有 SCADA/BMS 畫面上操作,額外要求他們每天登入另一套獨立的 AI 儀表板,往往會因為「多一個系統要看」而降低實際使用率,長期下來系統形同虛設。把智慧化的判斷結果,包裝成現場人員熟悉介面上的一則告警或一個健康分數欄位,才能真正融入既有的工作流程,而不是增加額外的認知負擔。
| 通訊協定 | 適用場景 | 特性 |
|---|---|---|
| 4-20mA | 類比訊號,PLC/SCADA 類比輸入卡 | 最通用、抗干擾佳,但無數位診斷資訊,需獨立佈線 |
| HART | 在既有 4-20mA 迴路上疊加數位通訊 | 可讀取感測器狀態、量程、診斷碼,不需額外佈線 |
| RS-485 Modbus RTU/TCP | 多點感測器串接、Edge Gateway 輪詢 | 單一迴路可掛多台,具備工程單位、狀態碼等結構化資料 |
| OPC UA | SCADA/歷史資料庫 ↔ AI 分析平台 | 跨廠牌標準化、內建憑證加密,支援 Pub/Sub 即時串流 |
| BACnet / Modbus | BMS(空調、電力、消防等建築設備) | 建築自動化業界主流協定,多數品牌 BMS 皆可對接 |
| MQTT | Edge → 雲端/IT 端事件推播 | 輕量發布/訂閱架構,適合大量感測點低頻寬回傳 |
下方提供一段架構參考範例,示意 Edge Gateway 如何透過 RS-485 Modbus 讀取智慧型壓力/溫度傳送器,經過本地正規化後,再以 MQTT 發佈事件供上層 SCADA/AI 平台訂閱。此範例僅供工程團隊理解資料流向,實際部署仍需依貴公司網路架構、資安規範與既有系統版本調整:
# ===== 檔案:edge_gateway_reference.py(架構參考範例,非正式產品程式碼)=====
# 功能:從 Modbus RTU 感測器讀取壓力/溫度數值,正規化後以 MQTT 發布
# 執行環境示意:工業電腦 / Raspberry Pi 等級 Edge Gateway

import time
# import minimalmodbus         # 需自行安裝對應 Modbus 函式庫
# import paho.mqtt.client as mqtt

SENSOR_CONFIG = [
    {"tag": "P-101", "slave_id": 1, "register": 0, "unit": "bar", "scale": 0.01},
    {"tag": "T-101", "slave_id": 2, "register": 0, "unit": "degC", "scale": 0.1},
]

def read_modbus_register(slave_id, register):
    # instrument = minimalmodbus.Instrument('/dev/ttyUSB0', slave_id)
    # instrument.serial.baudrate = 9600
    # raw_value = instrument.read_register(register, functioncode=4)
    # return raw_value
    return 0  # 佔位示意,實際串接請依感測器通訊手冊調整

def normalize_and_publish(mqtt_client):
    for sensor in SENSOR_CONFIG:
        raw = read_modbus_register(sensor["slave_id"], sensor["register"])
        value = raw * sensor["scale"]
        payload = {
            "tag": sensor["tag"],
            "value": value,
            "unit": sensor["unit"],
            "timestamp": time.time(),
        }
        # mqtt_client.publish(f"plant/edge/{sensor['tag']}", str(payload))
        print(payload)  # 示意輸出,正式環境請改為發布至 MQTT Broker

if __name__ == "__main__":
    # client = mqtt.Client()
    # client.connect("edge-broker.local", 1883)
    while True:
        normalize_and_publish(mqtt_client=None)
        time.sleep(5)
整條資料流以文字化流程表示如下:
[壓力/溫度智慧型傳送器]
        │ RS-485 Modbus RTU / HART / 4-20mA
        ▼
[Edge Gateway:正規化、時間同步、Lv.2 異常偵測]
        │ MQTT(事件)/ OPC UA(結構化資料流)
        ▼
[SCADA 歷史資料庫 / BMS 控制器] ──┬── 現場 HMI 警報
        │ OPC UA / API                 └── 工作單自動派工(CMMS)
        ▼
[AI 分析平台:趨勢分析、剩餘壽命預測、健康分數]
1.5 歷史資料庫與資料治理——AI 模型的長期糧草
許多團隊在規劃架構時,會把重心全部放在「即時告警」,卻忽略了歷史資料的留存策略。AI 模型(尤其是 Lv.3 的剩餘壽命預測)需要長期、乾淨、可信賴的歷史資料才能持續進化,而歷史資料庫(Historian)的規劃品質,直接決定了未來能否回溯分析、能否重新訓練模型、能否通過稽核。以下是幾個實務上建議優先確認的資料治理原則:
- 保留原始未經抽稀的資料:許多歷史資料庫預設會做「等間隔抽樣」以節省儲存空間,但這會讓瞬態異常(例如尖峰負載時的快速壓力波動)遺失。建議採用異常值觸發式記錄邏輯,在數值變化超過設定門檻時才記錄,兼顧儲存效率與資料完整性。
- 保留品質旗標(Quality Flag):感測器訊號異常、通訊中斷等「壞資料」時段,往往正是故障前兆最明顯的時間點,不應該被視為無效資料而刪除,反而應標記後保留供後續分析。
- 統一時間戳與時區:跨系統整合時(尤其是感測層與 SCADA 分屬不同廠牌),時間同步誤差會讓多感測融合分析產生錯誤的因果推論,建議所有節點統一使用 NTP 校時。
- 資料保存年限:建議至少保留 2 年歷史資料,涵蓋至少一個完整的季節循環,特別是對於 HVAC、電力設備等具明顯季節性負載的場域。
- 標籤命名一致性:Edge 層正規化階段,應統一感測點位的命名規則,避免同一物理量測點在不同系統中有不同名稱,造成後續資料串接的額外工程成本。
1.6 資安框架——OT/IT 整合不能省略的一步
當感測資料開始從 OT(操作技術)網路流向 IT(資訊技術)網路的 AI 分析平台,攻擊面也隨之擴大。國際自動化學會(ISA)與國際電工委員會(IEC)共同制定的 IEC 62443 系列標準,是目前工業控制系統資安領域最廣泛採用的框架,其核心概念包括:
| 資安概念 | 實務作法 |
|---|---|
| 網路區隔(Zone & Conduit) | OT 網路與 IT 網路之間設置 DMZ 閘道,避免直接暴露控制系統於企業網路 |
| 憑證式身分驗證 | OPC UA 內建支援憑證加密與身分驗證,取代明碼傳輸 |
| 最小權限原則 | Edge Gateway 僅開放必要的讀取權限,避免具備改寫 PLC/SCADA 控制邏輯的能力 |
| 資安等級分級(SL 1-4) | 依系統風險等級(是否涉及安全連鎖、是否為關鍵基礎設施)分級管理防護強度 |
| 持續監控與異常偵測 | OT 網路流量異常,本身也可以是一種「資安事件」的異常偵測應用 |
實務建議:感測層與 Edge 層的規劃階段,就應該邀請資訊安全團隊一起參與網路架構設計,而不是等系統上線後才補強資安措施。
1.7 取樣頻率與延遲需求對照表
不同應用情境對「多快要知道異常」的要求差異很大,過度追求最低延遲會墊高不必要的硬體成本,延遲需求設定過鬆又可能錯過關鍵的反應時間窗。以下提供概略對照,協助工程團隊在規劃階段設定合理的取樣頻率與延遲目標:
| 應用情境 | 建議取樣頻率 | 可接受延遲 | 典型技術選擇 |
|---|---|---|---|
| 安全連鎖保護(防爆、超壓保護) | 連續(毫秒等級) | < 15 毫秒 | 本地 Edge 端即時判斷,不依賴雲端 |
| 旋轉機械早期異常偵測 | 1~10 秒/筆 | 分鐘等級 | Edge 端異常偵測 + 定期回傳趨勢 |
| HVAC/BMS 空調監控 | 10~60 秒/筆 | 數分鐘至數十分鐘 | BMS 既有輪詢週期即可涵蓋 |
| 剩餘壽命長期趨勢預測 | 分鐘至小時等級彙總 | 小時至天等級 | 雲端或中控室歷史資料庫分析 |
| 巡檢輔助讀值比對 | 依人工巡檢週期 | 無即時性要求 | 手持或藍牙數位儀表 |
掌握這個對照關係,有助於避免「為了不需要的低延遲,投入過高的硬體成本」,或反過來「延遲設定過鬆,導致真正需要即時反應的安全連鎖場景來不及應變」。
1.8 延伸至其他物理量的整合可能性
雖然本文聚焦於壓力與溫度這兩項最基礎、應用最廣的物理量,但實務上,多數預測性維護專案在感測層擴充到一定規模後,往往會進一步納入液位、差壓等相關量測,形成更完整的資產健康監控網路。例如:儲槽或反應釜除了監測本體壓力與溫度,液位變化也是判斷洩漏或製程異常的重要指標;空壓機與過濾系統除了壓力監控,差壓數據更能直接反映濾網阻塞程度。由於這些物理量在 Edge/AI 架構中的資料處理邏輯高度相似(同樣是連續數位訊號、同樣需要正規化與異常偵測),建議在規劃感測層架構時,一併評估是否有液位、差壓等擴充需求,避免日後需要重新設計資料介接邏輯。
第二章:尖峰負載與異常關聯分析——數字會說話
多數設備故障不是「突然」發生的,而是在尖峰負載(開機瞬間、滿載運轉、季節性用電高峰、批次製程切換)時,壓力或溫度先出現微幅偏移,只是幅度小到人工巡檢看不出來,也不足以觸發傳統 SCADA 的固定閾值告警。等到偏移擴大到「人眼看得出來」或「觸發跳機保護」的程度,往往已經進入故障後期,維修成本與停機損失也隨之放大。
這個現象背後的物理原理並不難理解:多數機電設備在額定負載下運轉時,各項物理量都落在設計容許範圍內;但當負載提升到接近上限(例如夏季空調系統滿載、產線批次切換瞬間的電流衝擊),設備內部的應力、摩擦、熱累積都會同步放大,任何潛在的劣化(軸承磨損、密封件老化、散熱效率下降)都會在這個時刻被「放大檢視」。這也是為什麼許多故障看似發生在「平常的尖峰時段」,而不是設備運轉最輕鬆的離峰時間——尖峰負載其實是設備健康狀態的天然壓力測試。
2.1 常見設備的壓力/溫度異常前兆與可預警時間窗
下表整理五類常見工業設備的典型異常前兆與可預警時間窗,這些數字為業界統計的概略區間,實際天數會因設備型號、運轉條件與維護歷史而有所差異,但共同的重點是:幾乎所有機電設備的故障,都會先在壓力或溫度訊號上留下痕跡,只是這個痕跡通常很微小,需要連續且精確的量測才能捕捉到。
| 設備類型 | 典型異常前兆訊號 | 可提前偵測時間窗 | 未預警的典型後果 |
|---|---|---|---|
| 旋轉機械(幫浦、風車、壓縮機) | 軸承溫升、進出口壓差擴大、振動伴隨壓力波動 | 2~6 週 | 軸承卡死、非計畫性停機、二次損壞擴及連軸設備 |
| HVAC 冰水主機/空調箱 | 冷媒壓力偏離設計曲線、蒸發器溫度異常爬升 | 14~30 天 | 冷房能力下降、能耗上升 15~30%、舒適度客訴 |
| 反應釜/製程管線 | 夾套壓力波動、進料溫度異常、壓力釋放頻率上升 | 數小時~數天(視製程速率) | 批次報廢、洩漏風險、安全連鎖跳機 |
| 電力設備(變壓器、開關櫃) | 油壓/氣壓異常、殼體溫升、局部放電伴隨溫度熱點 | 數週~數月 | 絕緣劣化加速、跳電、設備報廢 |
| 壓縮空氣/真空系統 | 管路壓損擴大、乾燥機露點異常 | 1~4 週 | 洩漏能耗浪費、下游氣動元件故障率上升 |
2.2 尖峰負載期間的資料密度需求
值得注意的是,異常前兆往往集中在負載變化的瞬間——開機啟動、換批切換、日間用電尖峰、季節轉換(例如夏季空調滿載)。如果感測取樣頻率在這些時段被稀釋(例如巡檢式量測只在固定時間點記錄),系統很容易「錯過」關鍵訊號。以下以一般工廠常見的三種監控密度做比較:
| 監控方式 | 取樣頻率 | 尖峰負載捕捉能力 | 資料可用於 AI 建模程度 |
|---|---|---|---|
| 人工巡檢(紙本記錄) | 每日 1~3 次,固定時段 | 幾乎無法捕捉瞬態異常 | 不可用,無法建立時序模型 |
| 傳統 SCADA 固定閾值監控 | 連續,但僅記錄超限事件 | 可捕捉明顯異常,錯過緩慢飄移 | 有限,缺乏正常區間的趨勢資料 |
| 連續數位感測 + Edge 前處理 | 1~10 秒/筆,全時段連續 | 可完整捕捉尖峰負載瞬態與緩慢趨勢 | 高,可支援 Lv.2~Lv.3 AI 模型訓練 |
2.3 停機成本量化:為什麼「早 2 週知道」很值錢
以一般中大型製造廠或設施管理場域為例,非計畫性停機的成本可拆解為四個層面:直接維修成本(零件+人工+加班)、產能損失(停機時段的產出價值)、二次損壞成本(單一元件故障拖累相鄰設備)、以及安全與合規風險成本(若涉及壓力容器、防爆區域)。導入連續感測 + AI 異常偵測後,多數案例回報的效益集中在「把非計畫性停機轉為計畫性維護」,讓維修排程可安排在低產能衝擊的時段執行,同時避免二次損壞擴大。
2.4 從單點異常到系統性風險——為什麼要跨設備比對
單一感測點的異常,有時候只是局部現象;但當壓力與溫度的異常同時出現在多個關聯設備上(例如同一條冷卻迴路的多台幫浦、同一段製程管線的多個監測點),往往代表的是系統性風險,而非單一元件故障。這也是為什麼多感測融合與跨系統關聯分析,會比單點閾值告警更有價值——透過比對同一時間窗內多個監測點的異常分數,AI 模型可以進一步判斷這是「單點故障前兆」還是「上游系統性問題(例如冷卻水泵浦效率下降,導致下游多台設備溫度同步上升)」。實務上,這類跨系統關聯分析的告警提前量,普遍可達 45~90 分鐘,讓維護與製程人員有足夠時間介入,避免異常擴散為批次性損失。
2.5 從資料到決策——別讓儀表板變成「沒人看的告警牆」
值得提醒的是,再完整的感測與 AI 架構,如果產出的告警沒有對應的標準作業流程(SOP)與負責人員,最終只會變成「沒人看的告警牆」。業界常見的失敗模式是:系統上線初期告警氾濫(門檻設定過於敏感),維護人員逐漸養成「先忽略再說」的習慣,等到真正重要的告警出現時,反而被淹沒在雜訊中而錯過。建議在系統上線初期,安排 1~2 個月的「觀察期」,讓維護團隊與 AI 模型互相磨合:維護人員回饋哪些告警是有意義的、哪些是誤報,模型門檻再依此持續校正,才能讓告警系統真正被信任與採用。
下一章,我們會把上述架構落地為具體的儀表選型清單,說明在感測層、Edge 層、整合層分別需要哪些規格的壓力與溫度儀表,並以表格化方式呈現各類場域的建議配置。
第三章:完整儀表清單與配置建議
本章依「感測層 → Edge 整合層」的實際需求,整理出五大應用場景的儀表配置建議。昶特 ATLANTIS 所有壓力/溫度儀表皆採報價制,實際型號、量程、材質與數量需依現場圖面與製程條件確認,以下配置僅供架構規劃參考。
閱讀以下表格時,建議搭配第一章的通訊協定說明與第三章末尾的選型檢查清單一起參考——同一個監測位置,往往有多種儀表類型都能滿足基本量測需求,真正的差異在於輸出介面是否符合現場既有系統、環境耐受性是否足夠,以及長期使用下的穩定度與維護便利性。
3.1 旋轉機械監控(幫浦、壓縮機、風車)
旋轉機械是多數工廠故障頻率最高的設備類型,軸承磨損、密封件老化、不平衡等問題,幾乎都會先反映在進出口壓差與機殼溫度的緩慢變化上。以下配置以「壓力+溫度雙訊號」為核心監測邏輯:
| 監測位置 | 建議儀表類型 | 輸出介面 | 備註 |
|---|---|---|---|
| 進/出口壓力 | HART智能型壓力傳送器(SDPT-3100系列) | 4-20mA + HART | 可疊加通訊診斷,判斷感測器本體健康度 |
| 軸承/機殼溫度 | 白金電阻溫度計(RTD-907A系列) | PT100 / 4-20mA選配 | 精度可達 ±0.1°C~±0.3°C,適合緩慢飄移偵測 |
| 差壓(濾網阻塞監測) | 差壓傳送器(DPT-AC / DPT-A系列) | 4-20mA + HART | 可監測濾網、管路阻塞趨勢 |
| 巡檢輔助讀值 | 藍牙數位壓力錶(DPG-X112系列) | 藍牙 + 本地顯示 | 適合無固定佈線點位的巡檢式監控 |
3.2 HVAC/空調系統與 BMS 整合
空調系統的異常往往與季節性負載高度相關,夏季滿載運轉時的冷媒壓力與送風溫度變化,是判斷冰水主機、空調箱是否需要提前維護的關鍵指標,同時也是最容易與既有 BMS 系統整合的應用場景之一:
| 監測位置 | 建議儀表類型 | 輸出介面 | 備註 |
|---|---|---|---|
| 冷媒系統壓力 | 製冷行業壓力傳送器(PT-RF321系列) | 4-20mA | 專為冷媒相容材質設計 |
| 送風/迴風溫濕度 | 高精度工業溫濕度傳送器(AT-THM80系列) | 4-20mA / RS-485 Modbus | 同時監測溫度與濕度,適合 BMS 對接 |
| 水側系統溫度 | HART智能型溫度傳送器(STT系列) | 4-20mA + HART | 可對應多種熱電偶/電阻式感溫元件 |
| 低壓警戒點 | 數位壓力開關(DPS系列) | 開關訊號 + 數位顯示 | 可設定本地告警閾值,作為 AI 判斷前的第一道防線 |
3.3 製程反應釜與高風險環境
石化、化工等製程反應釜的監測需求最為嚴苛,除了壓力與溫度的即時準確度,防爆認證與耐腐蝕材質往往是選型的第一道門檻,配置時建議優先確認現場防爆區域等級與介質相容性:
| 監測位置 | 建議儀表類型 | 輸出介面 | 備註 |
|---|---|---|---|
| 反應釜本體壓力 | 防爆壓力傳送器(PTX-CC系列) | 4-20mA + HART,防爆認證 | 適用防爆區域,支援 HART 遠端診斷 |
| 夾套/導熱油溫度 | 防爆溫度傳送器(ATTX-200系列) | 4-20mA + HART,防爆認證 | 高溫環境設計,可承受製程溫度波動 |
| 超高壓製程點 | 超高壓型壓力傳送器(PT-UHP系列) | 4-20mA | 適用高壓製程與測試設備 |
| 現場人工確認 | 數位隔測溫度錶(DTG-FT系列) | 本地數位顯示 | 供人員巡檢比對線上讀值,雙重驗證 |
3.4 電力設備監控(變壓器、開關站)
電力設備的故障往往牽動範圍最廣、影響最嚴重,變壓器油壓與繞組溫度的異常趨勢,通常是絕緣劣化的早期指標,建議與既有保護迴路並行監測,而非取代原有的安全保護機制:
| 監測位置 | 建議儀表類型 | 輸出介面 | 備註 |
|---|---|---|---|
| 變壓器油壓/氣壓 | 智慧型壓力傳送器(AT-PT186系列) | 4-20mA + 數位診斷 | 可連續監測油壓趨勢,配合溫度交叉分析 |
| 殼體/繞組溫度 | 滑動式接點溫度錶(ECS系列) | 本地開關 + 遠端擴充 | 可設定分段告警接點,銜接既有保護迴路 |
| 高溫環境監測 | 攜帶型數位熱電偶溫度計(ATFC-305A系列) | 本地顯示,手持巡檢用 | 適合定期巡檢比對固定點監測數值 |
3.5 壓縮空氣與公用系統
壓縮空氣系統的洩漏與效能衰退,是許多工廠長期被忽視的能耗黑洞,透過持續監測管路壓損與乾燥機露點趨勢,通常能在洩漏擴大前及早發現,同時作為能源管理績效的量化依據:
| 監測位置 | 建議儀表類型 | 輸出介面 | 備註 |
|---|---|---|---|
| 乾燥機露點/壓力 | 工業級高壓露點傳送器(DPPT-HP系列) | 4-20mA | 監測乾燥系統效能趨勢 |
| 管路壓損監測 | 數位微差壓錶(DMPG-X022系列) | 本地顯示 + 4-20mA選配 | 可用於評估管路/濾網阻塞程度 |
| 系統總壓監控 | 工業型數顯壓力傳送器(SPT-X系列) | 4-20mA + 本地顯示 | 兼具現場讀值與遠端傳輸功能 |
3.6 選型決策檢查清單
在正式送出詢價需求前,建議工程團隊先完成以下六項自我檢核,能大幅提升後續型號確認的效率,也能避免因為規格漏未確認而導致的交期延誤:
- ✅ 確認現場既有系統的通訊介面(4-20mA類比卡?RS-485?是否已有 HART Modem?)
- ✅ 確認環境條件:溫度範圍、是否防爆區、是否有腐蝕性介質
- ✅ 確認所需精度等級:一般監控用 ±1% FS 已足夠;早期異常偵測建議 ±0.5% FS 以上
- ✅ 確認取樣頻率需求:僅供巡檢比對 vs. 需連續上傳 Edge/AI 平台
- ✅ 確認校正週期規劃:依 ISO 17359/ISO 18436 建議,建立可稽核的校正紀錄
- ✅ 確認資料歷史留存需求:AI 模型訓練建議至少 2~4 週基準資料,季節性設備建議留存 1 年以上
3.7 常見選型錯誤案例
在協助客戶規劃感測層配置的過程中,以下幾種選型錯誤最為常見,提前避開可以省下不少後續返工成本:
| 常見錯誤 | 可能後果 | 建議做法 |
|---|---|---|
| 量程選得過大(例如實際運轉壓力僅 2 bar,卻選用 0~100 bar 量程) | 有效解析度不足,無法偵測早期微幅飄移 | 建議選用「正常運轉壓力落在量程 50~80% 區間」的型號 |
| 忽略介質相容性(腐蝕性介質使用一般不銹鋼材質) | 感測膜片腐蝕,精度快速衰退甚至洩漏 | 依製程介質特性選用對應耐腐蝕材質或隔離膜片設計 |
| 防爆區域誤用一般型號 | 不符合現場法規要求,稽核無法過關 | 導入前務必確認現場防爆區域劃分等級,選用對應認證型號 |
| 只顧慮感測器精度,忽略配線與訊號轉換品質 | 整體系統精度被低品質類比轉換環節拉低 | 感測層升級時,同步檢視訊號轉換卡、接地與屏蔽線品質 |
| 取樣頻率設定過低以節省資料量 | 錯過尖峰負載期間的瞬態異常訊號 | 依第二章建議,確保取樣頻率涵蓋尖峰負載完整波形 |
所有型號皆採報價制,實際規格、量程與交期請透過 昶特 ATLANTIS 快速詢價表單 提供現場圖面與需求,將由業務工程團隊協助確認最終配置。
第四章:昶特 ATLANTIS 推薦方案——為 Edge/AI 資料鏈打好地基
昶特 ATLANTIS 深耕台灣工業儀表製造領域 31 年,產品線涵蓋壓力、溫度、液位等量測儀表,全數為自有品牌設計製造,而非單純代理轉售。對於正在規劃「壓力/溫度感測 → Edge → AI → SCADA/BMS」資料骨幹的工程團隊而言,感測層的選型往往決定了後續整條鏈路的穩定度——訊號漂移、校正週期混亂、防護等級不足,都會讓後端 AI 模型學到錯誤的「正常基準」。以下依應用情境,介紹幾款適合作為預測性維護資料骨幹起點的儀表。
「自有品牌設計製造」這件事,對於預測性維護專案而言,其實有著超越品牌形象的實質意義:當感測器出現異常讀值,需要判斷「是設備真的異常」還是「感測器本體訊號漂移」時,能否快速取得原廠技術支援、能否溯源到實際的製造與校正紀錄,往往是能否快速排除疑慮的關鍵。這也是為什麼在規劃長期監控架構時,感測層供應商的技術支援與品質穩定度,值得與量測精度規格一起放進選型考量。
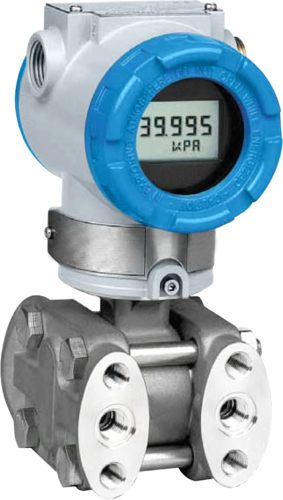
SDPT-3100 HART智能型壓力傳送器——4-20mA疊加HART通訊,可遠端讀取診斷資訊,適合作為 Edge Gateway 的主要壓力資料來源。

AT-PT186 智慧型壓力傳送器——內建數位診斷邏輯,適合作為旋轉機械與電力設備的連續壓力監測節點。

PTX-CC HART通訊防爆壓力傳送器——具備防爆認證,適用於石化、製程反應釜等高風險區域的壓力監測。
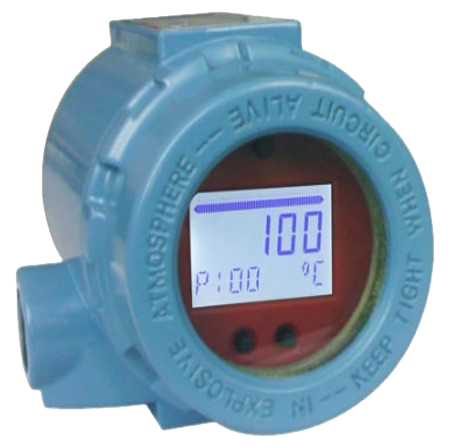
STT HART智能型溫度傳送器——可對應多種熱電偶/電阻式感溫元件,支援 HART 遠端組態與診斷。
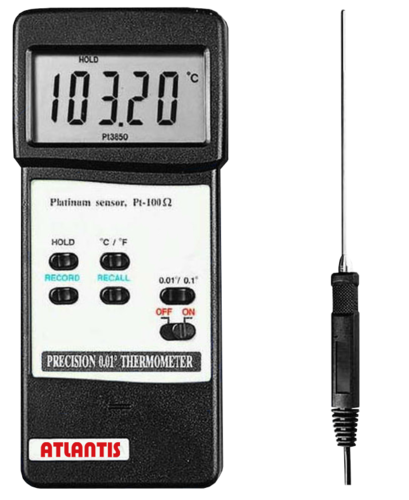
RTD-907A 白金電阻溫度計——PT100高精度感測,適合需要捕捉緩慢溫度飄移的早期異常偵測應用。

AT-THM80 高精度工業溫濕度傳送器——同時輸出溫度與濕度數據,適合 BMS 空調系統的整合監控。

DPG-X112 高精度藍芽數位壓力錶——無線數位輸出,適合缺乏固定佈線點位的巡檢式監控與臨時測試場景。

DPT-AC HART防腐型差壓傳送器——耐腐蝕材質設計,適合濾網阻塞監測與腐蝕性介質差壓量測。
4.1 為什麼從感測層開始規劃,而不是先買 AI 平台
許多企業導入智慧監控時,會先被 AI 平台或儀表板的展示效果吸引,卻忽略了「垃圾進、垃圾出」的基本原則。如果感測層的訊號本身不穩定、精度不足,再漂亮的儀表板也只是把雜訊視覺化。昶特 ATLANTIS 的產品設計邏輯,正是先確保感測本體的長期穩定度與訊號品質,讓後續無論是自行開發 Edge AI 系統,或委託系統整合商建置 SCADA/BMS 整合平台,都能建立在可信賴的資料基礎之上。
這也是為什麼在規劃預測性維護專案時,建議工程團隊把「感測層選型」與「AI 平台選型」拆成兩個獨立的決策——前者關乎量測物理量的準確度與長期穩定性,後者則關乎資料分析與演算法能力,兩者的評估標準完全不同,混在一起討論容易讓專案失焦,也容易在感測層投入不足的情況下,過早鎖定特定 AI 平台廠商。
4.2 一站式選型,降低多廠牌整合風險
當壓力、溫度、差壓、液位等不同量測需求分別來自不同廠牌時,工程團隊常需要面對規格不一致、校正週期不同步、備品管理分散等問題。昶特 ATLANTIS 提供橫跨壓力、溫度、液位、差壓的完整產品線,同一供應商可涵蓋多數現場監測點位,簡化長期維運與備品管理的複雜度。所有產品皆提供校正與技術支援服務,降低導入初期「選錯規格」的風險。
對於已經有多家儀表供應商的既有廠房而言,也不需要一次性全部替換——可先從新建點位或既有故障率較高的儀表開始,逐步統一為單一供應商體系,長期下來能有效減少備品種類與校正排程的管理複雜度。
4.3 從單點監控到全廠資料骨幹的擴充路徑
建議採取分階段導入策略,而非一次性全面更換所有儀表:
- ✅ 第一階段:針對關鍵設備(歷史故障率高、停機成本高)優先更換為數位輸出型儀表
- ✅ 第二階段:建置 Edge Gateway,串接第一階段儀表,累積 2~4 週基準資料
- ✅ 第三階段:導入 Lv.2 異常偵測模型,並將告警事件整合進既有 SCADA/BMS
- ✅ 第四階段:擴充至次要設備點位,逐步建立全廠資料骨幹與剩餘壽命預測能力
4.4 常見迷思澄清
💡 迷思一:「先買 AI 平台,感測器之後再升級」
這個順序在實務上經常導致專案卡關。AI 平台若沒有足夠精度與頻率的感測資料可用,只能先用既有的低品質資料訓練模型,等到後續感測層升級後,過去累積的資料又無法沿用,等於重新來過。建議至少先確認關鍵設備的感測層規格達標,再著手 AI 模型開發,才能讓投入的每一分資源都被有效利用。
💡 迷思二:「所有監測點都要用最高精度的儀表」
並非所有監測點都需要 ±0.1% FS 的高精度傳送器。建議依「故障影響程度」分級配置:關鍵設備(高停機成本、高安全風險)採用高精度數位輸出型儀表;次要設備可維持一般精度的巡檢型儀表,待資料骨幹擴充時再逐步升級,避免初期投入過度分散。
💡 迷思三:「裝了感測器跟 AI 就等於預測性維護做好了」
感測與 AI 只是資料骨幹的技術基礎,真正決定成效的,是後續的組織流程——告警是否有人負責處理、維護 SOP 是否配合更新、模型門檻是否隨著回饋持續校正。技術與流程必須同步建置,才能真正把「資料」轉換成「維護決策」。
4.5 產業應用地圖
「壓力/溫度感測 → Edge → AI → SCADA/BMS」這套架構並非單一產業專屬,以下整理幾個常見產業的應用重點與感測層需求特性:
| 產業別 | 關鍵監測設備 | 感測層需求特性 |
|---|---|---|
| 半導體/電子製造 | 廠務動力站、純水系統、氣體供應管路 | 高精度、低污染材質、連續 24 小時監控 |
| 石化/化工 | 反應釜、儲槽、管線 | 防爆認證、耐腐蝕材質、高溫高壓耐受性 |
| 食品/製藥 | 殺菌設備、冷鏈倉儲、無菌製程管線 | 衛生級材質、可清洗設計、法規稽核可追溯性 |
| 商辦/醫療大樓 BMS | 冰水主機、空調箱、電力系統 | 與既有 BMS 協定相容(BACnet)、易於巡檢比對 |
| 電力/能源基礎設施 | 變壓器、開關站、發電設備 | 長期穩定度、極端環境耐受性、與既有保護迴路整合 |
| 資料中心 | 不斷電系統、空調系統、發電機組 | 高可靠度、快速異常反應時間、與監控中心即時串接 |
不同產業的感測層需求雖有差異,但整體架構邏輯是一致的:先確保感測層資料品質,再逐步疊加 Edge、AI、SCADA/BMS 整合能力。
4.6 不同規模企業的導入策略比較
企業規模與現有資訊團隊能量,會直接影響適合的導入路徑。以下提供概略的策略比較,供不同規模的企業參考:
| 企業型態 | 建議起點 | Edge/AI 建置方式 | 注意事項 |
|---|---|---|---|
| 大型企業(具備自動化/資訊團隊) | 關鍵設備優先,同步規劃全廠架構藍圖 | 自行開發 Edge Gateway 與 AI 模型,或委託系統整合商客製 | 建議及早導入資安框架,避免多廠區規模化時產生技術債 |
| 中型企業(資訊團隊人力有限) | 選定 3~5 台高故障頻率設備作為試點 | 採用現成的 Edge AI 模組或平台,降低自行開發負擔 | 建議尋找具備工業通訊經驗的系統整合商協助初期建置 |
| 小型企業/單一廠房 | 從 1~2 台關鍵設備開始,驗證效益後再擴充 | 可先以數位顯示型儀表 + 人工定期讀值比對開始,累積基礎資料 | 初期可暫緩投入 AI 模型,優先確保感測層資料品質與紀錄習慣 |
無論企業規模大小,核心原則不變:先確保感測層資料可信賴,再依組織能量決定 Edge/AI 建置的自主開發或委外程度。
4.7 傳統儀表與智慧型儀表對照
為了讓採購與工程團隊更容易溝通升級的必要性,以下整理傳統指針式儀表與智慧型數位傳送器在預測性維護情境下的關鍵差異:
| 比較面向 | 傳統指針式儀表 | 智慧型數位傳送器 |
|---|---|---|
| 讀值方式 | 需人員現場目視讀取 | 連續數位輸出,可遠端讀取 |
| 資料留存 | 紙本記錄,難以系統化分析 | 自動留存於歷史資料庫,可追溯 |
| 異常反應時間 | 依巡檢週期,可能延遲數小時至數日 | 可即時告警,分鐘等級反應 |
| 診斷資訊 | 僅提供單一數值 | 可疊加狀態碼、量程、健康度等診斷資訊(HART/Modbus) |
| 是否支援 AI 分析 | 不支援,需人工轉錄才能使用 | 可直接饋入 Edge/AI 模型進行趨勢分析 |
| 長期維運成本 | 人力巡檢成本隨點位數量線性增加 | 初期建置成本較高,長期人力成本可顯著降低 |
這個對照表的重點不是「傳統儀表不好」,而是說明:如果目標是建立預測性維護資料骨幹,傳統指針式儀表無法提供連續、可追溯、可供 AI 分析的數位資料,這正是感測層升級的核心價值所在。
下一章,我們以一個匿名化的實際案例,說明這套分階段導入邏輯在真實場域中的落地過程與成效。
第五章:真實案例研究——從尖峰跳機到預測性維護
以下案例為求保護客戶隱私已完全匿名化,設施類型、規模與數據經過去識別化處理,僅保留具代表性的架構邏輯與改善幅度,供讀者參考規劃方向。
5.1 案例背景
個案為北台灣某精密製造廠的動力設備廠務區,廠內設有多組冰水主機、空壓機與變壓器,全廠 24 小時連續運轉。廠務團隊長期仰賴人工巡檢(每日 3 次固定巡檢路線),搭配傳統指針式壓力錶與雙金屬溫度計進行讀值記錄,SCADA 系統僅監控少數關鍵點位的固定閾值告警。
廠務團隊編制精簡,僅有 4 名輪班人員負責全廠動力設備的日常巡檢與維護,人力有限的情況下,異常訊號往往要等到巡檢時段才會被發現,若故障發生在巡檢間隔之間(尤其是夜間與假日),反應時間會被大幅拉長。這也是該廠務主管決定啟動感測層升級專案的主要動機——不是要取代人力,而是要讓有限的人力能更精準地聚焦在真正需要處理的異常上。
5.2 遭遇的問題
- ✅ 過去 12 個月內發生 4 次非計畫性停機,其中 2 次為空壓機軸承卡死,2 次為冰水主機冷媒系統異常
- ✅ 人工巡檢無法捕捉夜間與假日的異常趨勢,多起異常在巡檢間隔內快速惡化
- ✅ 傳統壓力錶精度不足,維護人員難以判斷「緩慢飄移」與「量測誤差」的差異,經常延遲反應
- ✅ 既有 SCADA 告警閾值設定過於寬鬆,多次異常在觸發告警前已造成設備損壞
- ✅ 缺乏歷史趨勢資料,每次故障後僅能事後歸因,無法建立預防機制
5.3 分階段導入方案(12個月)
| 階段 | 時間 | 導入內容 |
|---|---|---|
| 第一階段:基礎感測升級 | 第 1~2 個月 | 針對 4 次歷史故障相關設備,更換為 HART智能型壓力/溫度傳送器,建立連續數位訊號來源 |
| 第二階段:Edge Gateway 建置 | 第 2~3 個月 | 由廠內自動化團隊部署 Edge Gateway,串接新增儀表,累積基準運轉資料 |
| 第三階段:異常偵測模型訓練 | 第 4~6 個月 | 以 4 個月基準資料訓練 Lv.2 異常偵測模型,並與既有 SCADA 告警規則並行比對驗證 |
| 第四階段:SCADA/CMMS 整合 | 第 6~8 個月 | 異常事件回饋至 SCADA 警報清單,並串接既有工單系統,自動產生維護建議工單 |
| 第五階段:擴充與優化 | 第 8~12 個月 | 擴充至次要監測點位,並依 6 個月運轉回饋持續調整告警門檻,降低誤報率 |
值得留意的是,這五個階段並非完全依序進行,而是有部分重疊——第二階段的 Edge Gateway 建置,在第一階段感測層升級尚未全部完成時就已同步啟動;第四階段的 SCADA/CMMS 整合,也在第三階段模型驗證期間就開始進行介面規劃與測試環境建置。這種「重疊式」而非「接力式」的專案排程,是該廠務團隊能在 12 個月內完成整體導入的關鍵因素之一,也是多數成功案例的共同特徵:與其等每個階段完全結束才啟動下一階段,不如讓相鄰階段的準備工作提前交疊,縮短整體專案時程。
5.4 六個月後實際成效
系統於第六個月進入穩定運轉階段後,廠務團隊與資訊團隊共同針對四項核心指標進行前後比對,數據來自該廠內部的工單系統與 SCADA 歷史紀錄,以下呈現去識別化後的改善幅度:
| 指標 | 導入前 | 導入後(6個月) | 改善幅度 |
|---|---|---|---|
| 非計畫性停機次數 | 約 2~3 次/季 | 0~1 次/季 | ↓ 約 70~85% |
| 平均異常發現至排除時間 | 依人工巡檢週期,平均延遲 8~24 小時 | 15~30 分鐘內收到告警並排查 | 大幅縮短反應時間 |
| 告警有效性(真警報比例) | 約 30~40%(閾值告警誤報多) | 約 80~90%(異常偵測模型過濾後) | 顯著提升告警可信度 |
| 單次故障平均維修/停機成本 | 約 NT$150,000~NT$300,000/次(含產能損失) | 轉為計畫性維護,成本降至約 NT$20,000~NT$40,000/次 | ↓ 約 80~90% |
5.5 投資與回收分析
完整分階段導入週期
季度非計畫性停機次數變化
典型投資回收週期(依故障歷史頻率而定)
依此案例的改善幅度換算,減少的非計畫性停機成本與產能損失,在 6~10 個月內即可回收感測層升級與 Edge/AI 整合的投資,後續每年持續產生穩定的停機成本節省效益。實際投資金額因現場儀表數量、Edge Gateway 規模與是否委外系統整合而異,昶特 ATLANTIS 的儀表部分採報價制,建議依實際點位數量另行確認。
5.5b 敏感度分析:不同故障頻率下的回收週期
投資回收週期高度取決於現場設備的歷史故障頻率——故障愈頻繁、單次停機損失愈高的場域,感測層升級的投報比通常愈明顯。以下提供概略的敏感度分析,協助評估不同情境下的合理預期:
| 設備歷史故障頻率 | 單次停機損失等級 | 預期回收週期 |
|---|---|---|
| 高(每季 2 次以上) | 高(涉及安全風險或大量產能損失) | 3~6 個月 |
| 中(每季 1 次左右) | 中 | 6~12 個月 |
| 低(每年 1~2 次) | 低 | 12~24 個月,建議優先評估是否有更高投報比的設備 |
這也呼應第三章「3.7 常見選型錯誤案例」與第四章「4.3 從單點監控到全廠資料骨幹的擴充路徑」的建議:優先從故障頻率高、停機損失大的設備開始導入,能讓有限的預算發揮最大效益。換句話說,投資決策的順序,應該是先盤點設備風險等級,再決定投入規模,而不是反過來先設定預算上限,才回頭挑選哪些設備「勉強」納入範圍——後者容易導致真正高風險的設備,反而因為預算排擠而被延後處理。
5.6 導入過程中的實際挑戰
這個案例並非一路順遂。前兩個月,廠務團隊發現部分新裝設的智慧型傳送器讀值與既有 SCADA 顯示值有些微落差,經排查後發現是既有系統的類比訊號轉換卡精度不足所致,而非新儀表本身問題——這也凸顯了感測層升級時,同步檢視訊號轉換與接線品質的重要性,否則再精準的儀表本體,也可能被上游的類比轉換環節拉低整體精度。第四個月進入異常偵測模型訓練階段時,團隊也經歷了約 3 週的「誤報磨合期」,透過與資深維護人員逐一核對告警事件,才將模型門檻調整到可信賴的水準。
5.7 案例啟示
這個案例最關鍵的轉折點,並不是導入了多先進的 AI 演算法,而是先把感測層的資料品質補齊。在感測層升級之前,就算裝上再好的 AI 分析平台,模型學到的也只是「巡檢頻率不足、精度不夠」所製造出來的雜訊。這也呼應了本文一開始的核心論點:預測性維護的成敗,往往決定於資料骨幹最底層的那顆壓力錶或溫度計,是否夠準、夠即時、夠穩定。同樣重要的是,技術導入從來不是一次到位的專案,而是「感測層升級 → 資料累積 → 模型磨合 → 流程優化」的持續循環,需要維護團隊、自動化工程師與資訊團隊三方持續協作。
第六章:常見問答(FAQ)
以下整理工程團隊在規劃「壓力/溫度感測 → Edge → AI → SCADA/BMS」架構時最常提出的 22 個問題,依「基礎概念 → 選型與部署 → 技術細節 → 實務挑戰」的順序排列,方便讀者依自己關注的階段快速查找對應解答。
❓ Q0:「壓力/溫度感測 → Edge → AI → SCADA/BMS → 預測維護」到底是什麼意思?
這是一條完整的資料骨幹架構:壓力與溫度感測器負責量測物理量,Edge Gateway 在現場端做訊號正規化與初步異常偵測,AI 模型分析趨勢並預測剩餘壽命或異常風險,最後把結果回饋進工廠既有的 SCADA(監控與資料擷取系統)或 BMS(建築管理系統),讓維護人員能在既有操作介面上直接看到預測性維護建議,而不需要另外開一套新系統。
這五個節點並非各自獨立的產品,而是一套需要協同規劃的資料流程。實務上建議把它想像成一條「接力賽」:感測層跑第一棒,負責提供夠準確的原始數據;Edge 層跑第二棒,把雜亂的原始訊號轉換成乾淨、標準化的事件;AI 層跑第三棒,從事件中萃取出趨勢與風險;SCADA/BMS 跑最後一棒,把判斷結果轉換成現場人員看得懂、來得及反應的維護動作。任何一棒掉棒,整條鏈路的價值就會大打折扣。
❓ Q1:預測性維護和預防性維護(定期保養)有什麼不同?
預防性維護是依固定週期(例如每 3 個月)保養,不論設備當下狀態如何;預測性維護則是依據即時感測資料判斷設備實際健康狀態,在真正接近故障前才安排維護。兩者常搭配使用:關鍵設備採預測性維護,次要設備維持預防性維護週期,達到資源最佳分配。
❓ Q2:導入這套架構,昶特 ATLANTIS 能提供哪些協助?
昶特 ATLANTIS 專注於壓力與溫度感測儀表本體的設計製造,提供 4-20mA、HART、RS-485 Modbus、藍牙等多種數位輸出介面的儀表選型與技術諮詢。至於 Edge Gateway 韌體開發、AI 模型訓練、雲端平台(如 AWS/Azure)串接、SCADA/BMS 客製整合,屬於系統整合或資訊工程範疇,建議由貴公司資訊團隊或合作的系統整合商執行;我們可提供儀表通訊協定文件與技術支援,協助對接。
簡單來說,可以把整條資料骨幹想像成蓋房子:昶特 ATLANTIS 負責把地基(感測層)打得又深又穩,至於地基之上要蓋幾層樓、要用什麼建築風格(Edge/AI/雲端平台的技術選型),則交由貴公司自己的建築師團隊(資訊/自動化團隊)或委託的營造商(系統整合商)來規劃執行,我們隨時提供地基相關的技術資料與支援。
❓ Q3:我們廠內已經有 SCADA 系統,還需要另外建置 AI 平台嗎?
不一定需要全新平台。多數 SCADA 系統本身具備固定閾值告警功能,若只需要 Lv.1 監控已足夠;但若目標是提前 2~6 週偵測異常趨勢(Lv.2/Lv.3),則需要額外的異常偵測或時序預測模型,可以是獨立的 Edge AI 模組,也可以是雲端分析平台,再把結果以 OPC UA 或 API 方式回寫進既有 SCADA 標籤,不需要整個換掉現有系統。
判斷是否需要額外建置 AI 分析能力,可以先自問:現有 SCADA 的告警規則,是否只能在數值「已經超標」時才觸發?如果答案是肯定的,代表系統目前停留在事後反應階段,加裝異常偵測或預測模型,才能把反應時間從「故障後」提前到「故障前數週」。
❓ Q4:感測器要選 4-20mA、HART 還是 RS-485 Modbus?
| 情境 | 建議介面 |
|---|---|
| 既有系統只有類比輸入卡,佈線已完成 | 4-20mA |
| 想在既有 4-20mA 迴路上增加診斷功能,不想重新佈線 | HART |
| 新建點位,需要多台感測器共用一條迴路 | RS-485 Modbus |
| 無固定佈線點位,機動巡檢用途 | 藍牙數位輸出 |
實務上,同一座工廠內常會混合使用多種介面:既有點位維持 4-20mA 相容既有系統,新建關鍵點位改用 HART 或 RS-485 Modbus 取得更豐富的診斷資訊,機動巡檢點位則以藍牙數位錶補足人工比對需求,不需要強求全廠統一單一介面。
❓ Q5:Edge Gateway 需要多少運算能力才夠用?
視部署的 AI 模型複雜度而定。單一設備的簡單異常偵測(如孤立森林),一般工業電腦或樹莓派等級的硬體即可勝任;若需要多感測融合、影像辨識或即時毫秒級推論,則建議採用具備 AI 加速晶片的工業級邊緣運算模組。實際規格建議由負責 Edge 開發的團隊依模型需求評估。
一般來說,運算需求可依「監測點數量 × 模型複雜度」概略估算:數十個感測點的統計式異常偵測,入門級運算模組已足夠;若涉及數百個點位的即時多感測融合,或需要在毫秒等級完成連鎖保護判斷,則建議選用具備較高算力(如百 TOPS 等級以上)的工業級運算模組,並確保其工作溫度範圍符合現場環境(多數工業級模組可耐受 -40°C~85°C)。
❓ Q6:AI 異常偵測模型需要多少基準資料才能開始運作?
一般建議至少 2~4 週的正常運轉資料作為基準,涵蓋尖峰與離峰負載的完整波形;若設備運轉具明顯季節性(如空調系統),建議累積至少一個完整季節週期的資料,模型判斷準確度會更穩定。
❓ Q7:校正週期怎麼安排才符合 ISO 17359 稽核要求?
ISO 17359 要求狀態監控計畫需有明確的基準資料留存、人員訓練紀錄(對應 ISO 18436),以及可追溯的量測歷史。實務上建議依儀表製造商建議週期(通常為 6~12 個月)定期校正,並將校正紀錄與感測歷史資料一併保存,供稽核與異常回溯使用。
此外,校正紀錄建議與 AI 模型的基準資料時間軸對齊——如果校正後感測器讀值出現系統性偏移,模型的基準值也應同步調整,否則可能誤判為設備異常,而實際上只是感測器校正前後的量測基準改變。
❓ Q8:防爆區域的壓力/溫度傳送器有什麼特別要求?
防爆區域(如石化廠、天然氣設施)需選用具備對應防爆認證的儀表本體,並確認接線方式(本質安全迴路或隔爆型)符合現場防爆等級劃分。昶特 ATLANTIS 部分型號(如 PTX-CC、ATTX-200 系列)提供防爆認證版本,實際適用區域等級建議與現場電機技師確認。
❓ Q9:BMS 系統要如何對接 AI 異常偵測結果?
多數 BMS 系統支援 BACnet 或 Modbus 協定,AI 分析平台可將異常事件、健康分數以對應協定寫入 BMS 的虛擬點位(Virtual Point),再由 BMS 既有的警報邏輯顯示於操作人員的監控畫面,不需要額外訓練人員使用新介面。
實務上建議在導入初期,先與 BMS 系統商或維護廠商確認虛擬點位的新增方式與授權範圍,部分 BMS 系統對第三方寫入點位有授權限制,提前確認可避免專案中期卡關。
❓ Q10:Modbus 跟 OPC UA 差異是什麼,該選哪個?
Modbus 是較早期、結構簡單的通訊協定,適合感測器與 Edge Gateway 之間的點對點資料讀取;OPC UA 則是較新的跨廠牌標準,具備結構化中繼資料、憑證加密與 Pub/Sub 即時串流能力,更適合 SCADA 歷史資料庫與 AI 分析平台之間的資料交換。多數架構會同時使用:感測層用 Modbus/HART,整合層用 OPC UA。
❓ Q11:感測資料量很大,會不會佔用太多網路頻寬?
如果把每個感測點的原始波形都直接上傳雲端,確實會佔用大量頻寬。這正是 Edge 層存在的價值——在現場端完成資料壓縮與初步判斷,僅將「事件」(如異常分數、告警旗標、統計摘要)上傳,原始高頻資料保留在本地儲存,需要時再依需求擷取,可大幅降低頻寬與雲端儲存成本。
以一個中型廠房為例,若有 50 個感測點、每秒取樣一次,若全部原始資料上雲,每日資料量可達數 GB 等級;透過 Edge 層僅上傳異常事件與定期統計摘要,可將實際上傳量壓縮到原始資料的 5~10% 以下,大幅降低網路與雲端儲存負擔。
❓ Q12:網路斷線時,Edge 端的異常偵測還能運作嗎?
可以。這也是 Edge 架構相對於純雲端方案的優勢之一:異常偵測模型部署在本地端,即使網路中斷,仍可持續執行監測與告警邏輯,待網路恢復後再同步歷史資料。對於需要即時連鎖保護的高風險設備,這項離線韌性尤其重要。
❓ Q13:如何避免 AI 模型產生太多假警報(alarm fatigue)?
常見做法包括:(1)採用多感測融合而非單一訊號判斷,降低單點雜訊造成的誤報;(2)建立分級告警機制,區分「觀察」與「立即處理」等級;(3)定期以實際維修回饋校正模型門檻;(4)確保基準資料涵蓋完整的正常運轉範圍,避免把正常波動誤判為異常。
另一個常被忽略的做法,是建立「告警回饋迴圈」:每次告警觸發後,請維護人員標註這次告警是「真異常」還是「誤報」,並把這個標註結果回饋進模型的持續訓練流程。長期累積下來,模型會逐漸學會貴公司特定設備的「正常波動範圍」,誤報率通常會隨著運轉時間拉長而持續下降。
❓ Q14:舊型 PLC/SCADA 系統(超過 10~15 年)可以整合嗎?
多數舊型系統可透過協定轉換器(Protocol Converter)或加裝獨立的 Edge Gateway 旁接方式整合,不需更動既有控制邏輯。若舊系統完全沒有數位輸出介面,也可考慮直接在關鍵監測點加裝具數位輸出的新型感測器,與舊系統並行運作。
需特別留意的是,部分超過 15 年的舊型 PLC 可能已無原廠技術支援,貿然連接外部裝置存在一定風險,建議在整合前先確認舊系統的通訊介面規格文件是否仍可取得,必要時可考慮以獨立感測器旁接的方式降低對既有系統的干擾。
❓ Q15:藍牙數位壓力錶(DPG-X112)適合用在連續監控嗎?
藍牙數位壓力錶較適合機動巡檢、臨時測試或無固定佈線點位的場景,因藍牙連線與電池續航特性,較不適合作為 24 小時連續上傳 Edge Gateway 的主要資料來源。連續監控建議選用有線 4-20mA、HART 或 RS-485 Modbus 輸出的傳送器型號。
❓ Q16:從傳統指針錶升級到智慧型傳送器,大概要多久導入?
依現場規模而定,單一設備點位的儀表更換與接線,通常數天內可完成;若涉及 Edge Gateway 建置與基準資料累積,完整看到 AI 模型可用的異常偵測結果,一般需要 1~3 個月;若目標是全廠規模的分階段導入,建議規劃 6~12 個月的完整週期(可參考第五章案例)。
建議不要一次性更換全廠所有儀表,而是採取分階段導入,先在少數關鍵設備上驗證整套流程(感測、Edge、AI、SCADA整合、告警回饋)都能順利運作,再逐步擴大範圍,可有效降低專案風險與初期投入。
❓ Q17:如何判斷該從哪些設備開始優先導入?
建議優先考量三個因素:(1)歷史故障頻率較高的設備;(2)單次停機成本或安全風險較高的設備;(3)現有巡檢或監控資料缺口最大的設備。同時符合這三項條件的設備,通常是投報比最高的起始點。
實務上可以簡單列一張表,把廠內設備依這三項因素評分排序,分數最高的前 3~5 台設備,通常就是最適合作為第一階段導入的試點對象,可參考第五章案例的分階段時程規劃。
❓ Q18:數位分身(Digital Twin)跟一般異常偵測有什麼不同?
一般異常偵測(Lv.2)著重於「現在的數值是否偏離正常模式」;數位分身則進一步建立設備的物理/數學模型,模擬不同運轉條件下的預期行為,能回答「這台設備還可以安全運轉多久」(剩餘壽命預測),屬於較高成熟度的 Lv.3 應用,通常需要更長的歷史資料累積與更完整的設備 FMEA(失效模式分析)對應。
建議多數企業從 Lv.2 異常偵測開始累積經驗與資料,待組織對資料驅動的維護決策更加熟悉、歷史資料也累積足夠長的時間後,再評估是否針對少數關鍵、高價值設備導入數位分身等級的 Lv.3 應用,避免一開始就投入過高複雜度的專案。
❓ Q19:這套架構有資安風險嗎?OT/IT 整合要注意什麼?
OT(操作技術)與 IT(資訊技術)網路整合確實會擴大攻擊面,建議導入時遵循 IEC 62443 等工業資安框架:包括 OT/IT 網路區隔(如 DMZ 閘道架構)、憑證式身分驗證(OPC UA 內建支援)、以及最小權限原則。感測器與 Edge Gateway 本身的資安設計,建議與資訊安全團隊共同規劃網路架構。
❓ Q20:如果不確定該選哪個型號,可以怎麼做?
建議直接提供現場圖面、既有系統通訊介面、環境條件(溫度範圍、是否防爆)與監測目標,透過 昶特 ATLANTIS 快速詢價表單 或聯繫業務工程團隊,將依實際需求提供對應型號建議與報價。
❓ Q21:儀表安裝後,後續的校正與技術支援怎麼安排?
昶特 ATLANTIS 提供產品校正與技術支援服務,可依前述 ISO 17359/ISO 18436 建議的週期安排定期校正,並協助排查通訊介面異常等技術問題。建議在專案初期就與業務工程團隊確認校正排程與備品規劃,納入長期維運計畫的一部分,而非等到儀表出現異常才臨時處理。
第七章:延伸閱讀——相關技術指南
想更深入了解本文提到的各項技術環節,可參考以下昶特 ATLANTIS 其他技術指南:
- OPC UA 工業標準選型指南:智慧工廠數據整合核心架構解析 —— 深入了解 SCADA 與 AI 平台之間的資料整合標準
- 工業控制系統訊號整合:4-20mA 與 Modbus 差異解析 —— 感測層通訊介面選型的完整比較
- 數位溫度傳送器與 IoT 監測方案:從工業現場到智慧化管理的完整指南 —— 溫度感測層的深入選型建議
- 數位壓力錶完全選型指南:從傳統儀表升級到智慧監控方案 —— 壓力感測層升級的實務步驟
- AI 用電暴增後,變電站最常見的壓力監測設備完整指南 —— 電力基礎設施的壓力監控應用案例
- 溫度傳送器完整指南:從工業測量到食品製藥監控的精密解決方案 —— 跨產業溫度感測應用參考
技術附錄:延伸程式範例與標準對照表
本附錄提供兩段延伸的架構參考範例,以及本文提及的國際標準快速對照表,供工程團隊在自行開發 Edge/AI 串接程式時參考。再次提醒:以下程式碼皆為概念性架構範例,非可直接部署的正式產品程式碼,實際串接請依現場設備通訊手冊、網路架構與資安規範調整。
之所以在一篇儀表選型指南中附上這些程式範例,是因為我們發現許多工程團隊在規劃階段最常卡關的地方,不是選不到適合的感測器,而是不確定「感測器輸出的訊號,最後要怎麼變成 AI 模型看得懂的資料」。這中間的轉換邏輯,往往才是真正需要跨部門溝通、反覆討論的環節。希望這些簡化過的參考範例,能幫助自動化工程師與資訊工程師之間,建立一個共同的討論基礎。
附錄A:健康分數(Health Score)計算邏輯參考
相較於單純的「正常/異常」二元判斷,許多預測性維護平台會計算一個連續的「健康分數」(例如 0~100 分),讓維護人員能直觀比較不同設備的相對風險,並依分數排序安排維護優先順序。以下為簡化版的健康分數計算邏輯範例:
# (架構參考範例)多訊號健康分數計算
# 目的:將壓力、溫度兩項訊號的偏移程度,轉換為單一健康分數
#
# def calculate_health_score(pressure_deviation, temperature_deviation, weight_p=0.5, weight_t=0.5):
#     """
#     pressure_deviation / temperature_deviation:
#         相對於基準值的標準化偏移量(0 = 完全正常,1 = 嚴重偏離)
#     weight_p / weight_t:
#         依設備特性調整的權重,例如旋轉機械可能溫度權重較高
#     """
#     risk_index = (pressure_deviation * weight_p) + (temperature_deviation * weight_t)
#     health_score = max(0, 100 - (risk_index * 100))
#     return round(health_score, 1)
#
# 範例:
# calculate_health_score(pressure_deviation=0.12, temperature_deviation=0.08)
# → 健康分數約 90 分(輕微偏移,持續觀察)
#
# calculate_health_score(pressure_deviation=0.45, temperature_deviation=0.38)
# → 健康分數約 58.5 分(建議排入近期維護排程)
這種將多項訊號濃縮為單一分數的做法,最大的好處是讓非技術背景的管理階層也能快速理解設備狀態——不需要看懂壓力曲線圖,只要看到健康分數從 90 分掉到 60 分,就知道這台設備需要優先安排維護資源。實務上,健康分數的權重設定建議與資深維護人員共同討論,依不同設備類型的故障模式調整壓力與溫度訊號的相對重要性。
附錄B:4-20mA 類比訊號轉換參考公式
對於仍使用傳統 4-20mA 類比訊號的既有系統,Edge Gateway 或 PLC 類比輸入卡讀取到的原始訊號,需先轉換為對應的工程單位(如 bar、°C),才能供後續 AI 模型使用。標準轉換公式如下:
# 4-20mA 轉換為工程單位參考公式
# 假設:量測範圍 0~10 bar,對應輸出 4~20mA
#
# def convert_4_20ma(raw_ma, range_min=0, range_max=10):
#     if raw_ma < 4 or raw_ma > 20:
#         raise ValueError("訊號超出 4-20mA 有效範圍,請檢查迴路或斷線")
#     engineering_value = range_min + ((raw_ma - 4) / (20 - 4)) * (range_max - range_min)
#     return round(engineering_value, 3)
#
# 範例:convert_4_20ma(12.0, range_min=0, range_max=10) → 3.75 bar
實務提醒:讀值若低於 4mA(例如接近 0mA),通常代表迴路斷線或感測器故障,而非量測值為負,建議在程式邏輯中加入斷線偵測,避免誤判為「壓力驟降」的異常事件。
附錄C:本文提及標準與協定快速對照表
| 標準/協定 | 制定單位 | 主要用途 |
|---|---|---|
| ISO 17359 | 國際標準化組織 | 機械狀態監控與診斷的總體程序框架 |
| ISO 13373 / ISO 13379 / ISO 13381 | 國際標準化組織 | 振動監測、診斷資料判讀、剩餘壽命預測的技術細節標準 |
| ISO 18436 | 國際標準化組織 | 狀態監控人員訓練與能力認證要求 |
| IEC 62443 | 國際電工委員會 / ISA | 工業自動化與控制系統資安框架 |
| HART | HART通訊基金會 | 在4-20mA迴路上疊加數位診斷通訊 |
| Modbus RTU/TCP | 產業界事實標準 | 感測器與控制器之間的輕量級數位通訊 |
| OPC UA | OPC基金會 | 跨廠牌、具加密能力的工業資料整合標準 |
| BACnet | ASHRAE | 建築自動化與控制系統通訊協定,BMS業界主流 |
| MQTT | OASIS標準組織 | 輕量發布/訂閱通訊協定,適合大量感測點的雲端回傳 |
附錄D:2026 產業趨勢觀察
觀察近期工業物聯網與邊緣運算產業發展,有幾個趨勢值得規劃預測性維護架構時一併留意。這些趨勢並非要求企業立即全面跟進,而是提供一個中長期的技術路線參考,讓現階段的感測層與 Edge 層投資,能盡量與未來 2~3 年的技術走向保持相容,避免過早鎖定即將被淘汰的規格:
- Edge AI 硬體持續平價化:具備 AI 加速能力的工業級邊緣運算模組,運算效能與能耗比逐年提升,讓過去只有大型企業能負擔的即時毫秒級推論,逐漸普及到中小型製造與設施管理場域。
- 多感測融合成為主流:單一訊號類型(如僅壓力或僅溫度)的異常偵測,正逐漸被壓力、溫度、振動、聲學等多訊號融合分析取代,主要驅動力是誤報率的大幅降低與診斷準確度的提升。
- 生成式 AI 開始應用於維護場景:部分平台開始整合自然語言查詢介面,讓維護人員可用口語化方式詢問設備狀態,降低資料分析的技術門檻;但也有研究機構提醒,過度複雜的自主化(Agentic AI)專案,若缺乏扎實的資料基礎,失敗率不低,建議循序漸進導入。
- 台灣供應鏈角色吃重:從晶片設計、感測元件製造,到邊緣運算硬體組裝,台灣在全球 Edge AI 產業鏈中扮演關鍵角色,對於本地工程團隊而言,取得相容硬體與技術支援的便利性持續提升。
- 資安要求逐漸標準化:隨著 OT/IT 整合案例增加,愈來愈多企業在導入預測性維護專案時,會同步要求供應商與系統整合商符合 IEC 62443 等資安框架,資安已從「加分項」逐漸變成「基本門檻」。
這些趨勢的共同結論是:技術門檻正在降低,但「資料骨幹是否打得穩」,仍然是決定專案成敗的核心關鍵——這也是本文從頭到尾反覆強調的重點。
結論:預測性維護,從一顆準確的壓力錶開始
「壓力/溫度感測 → Edge → AI → SCADA/BMS → 預測維護」這條資料骨幹,聽起來是一個高度技術性的 IT/OT 整合專案,但它的起點其實非常單純:一顆夠準、夠穩定、輸出介面對的壓力錶或溫度計。感測層做不好,後端無論是 Edge AI 演算法或 SCADA/BMS 整合平台,都只是在放大雜訊。反過來說,只要感測層打好地基,後續無論貴公司選擇自行開發 Edge Gateway、委託系統整合商建置 AI 平台,或分階段擴充監測範圍,都有一個可以信賴的資料起點。
昶特 ATLANTIS 深耕台灣工業儀表製造 31 年,專注於提供高精度、高穩定度的壓力與溫度感測儀表,並支援 4-20mA、HART、RS-485 Modbus、藍牙等多種數位輸出介面,作為貴公司預測性維護資料骨幹的堅實起點。後續的 Edge/AI/SCADA/BMS 整合工作,我們建議與貴公司資訊團隊或系統整合商協作完成,我們則在感測儀表的選型、規格確認與技術支援上,提供最直接的協助。
在規劃這類專案時,不妨反覆問自己三個問題:第一,我們對感測層的資料品質有信心嗎?如果連基礎的壓力與溫度讀值都不夠準確,後續投入的 AI 資源很可能只是在放大雜訊。第二,我們是否已經為告警建立了明確的處理流程與負責人?沒有人看的告警系統,再精準也毫無意義。第三,這套架構是否有清楚的分階段擴充路徑?與其追求一步到位的完美系統,不如從投報比最高的關鍵設備開始,逐步累積經驗與資料,讓整個組織跟著系統一起成長。想清楚這三個問題,往往比選擇哪個 AI 演算法更能決定專案的成敗。
需要協助規劃感測層配置嗎?
提供現場圖面與監測需求,昶特 ATLANTIS 業務工程團隊將協助確認儀表型號與規格(報價制)。
昶特有限公司 ATLANTIS|台北市北投區致遠一路二段 109 號
業務一部 Ian|業務二部 Nori|電話:02-2820-3405|傳真:02-2827-0646 / 02-2820-3406
官方網站:re-atlantis.tw